数据中台这个词,这几年被讲得很玄。这本《数据中台实战》反其道而行:不谈概念,只谈一件事——在一个多产品线的电商公司里,怎么把数据从埋点一路做到推荐。全书沿着「采集 → 存储与计算 → 打通 → 分析 → 应用」的顺序推进:先把数据采全、把指标算清、把用户连起来,再在数据底座上长出用户、商品、流量、交易四个分析场景,最后开放成自助分析、自动化营销、推荐三大平台。
一条主线:把数据建成底座,把分析做成业务,把能力开放成平台。
这本书的价值在于它把「数据中台」这个大词拆成了可以动手的工序:埋点怎么设计、指标怎么拆解、标签怎么生成、人群怎么圈选、分析场景各看什么数、平台怎么开放给业务。下面这张结构图,就是全书的骨架。
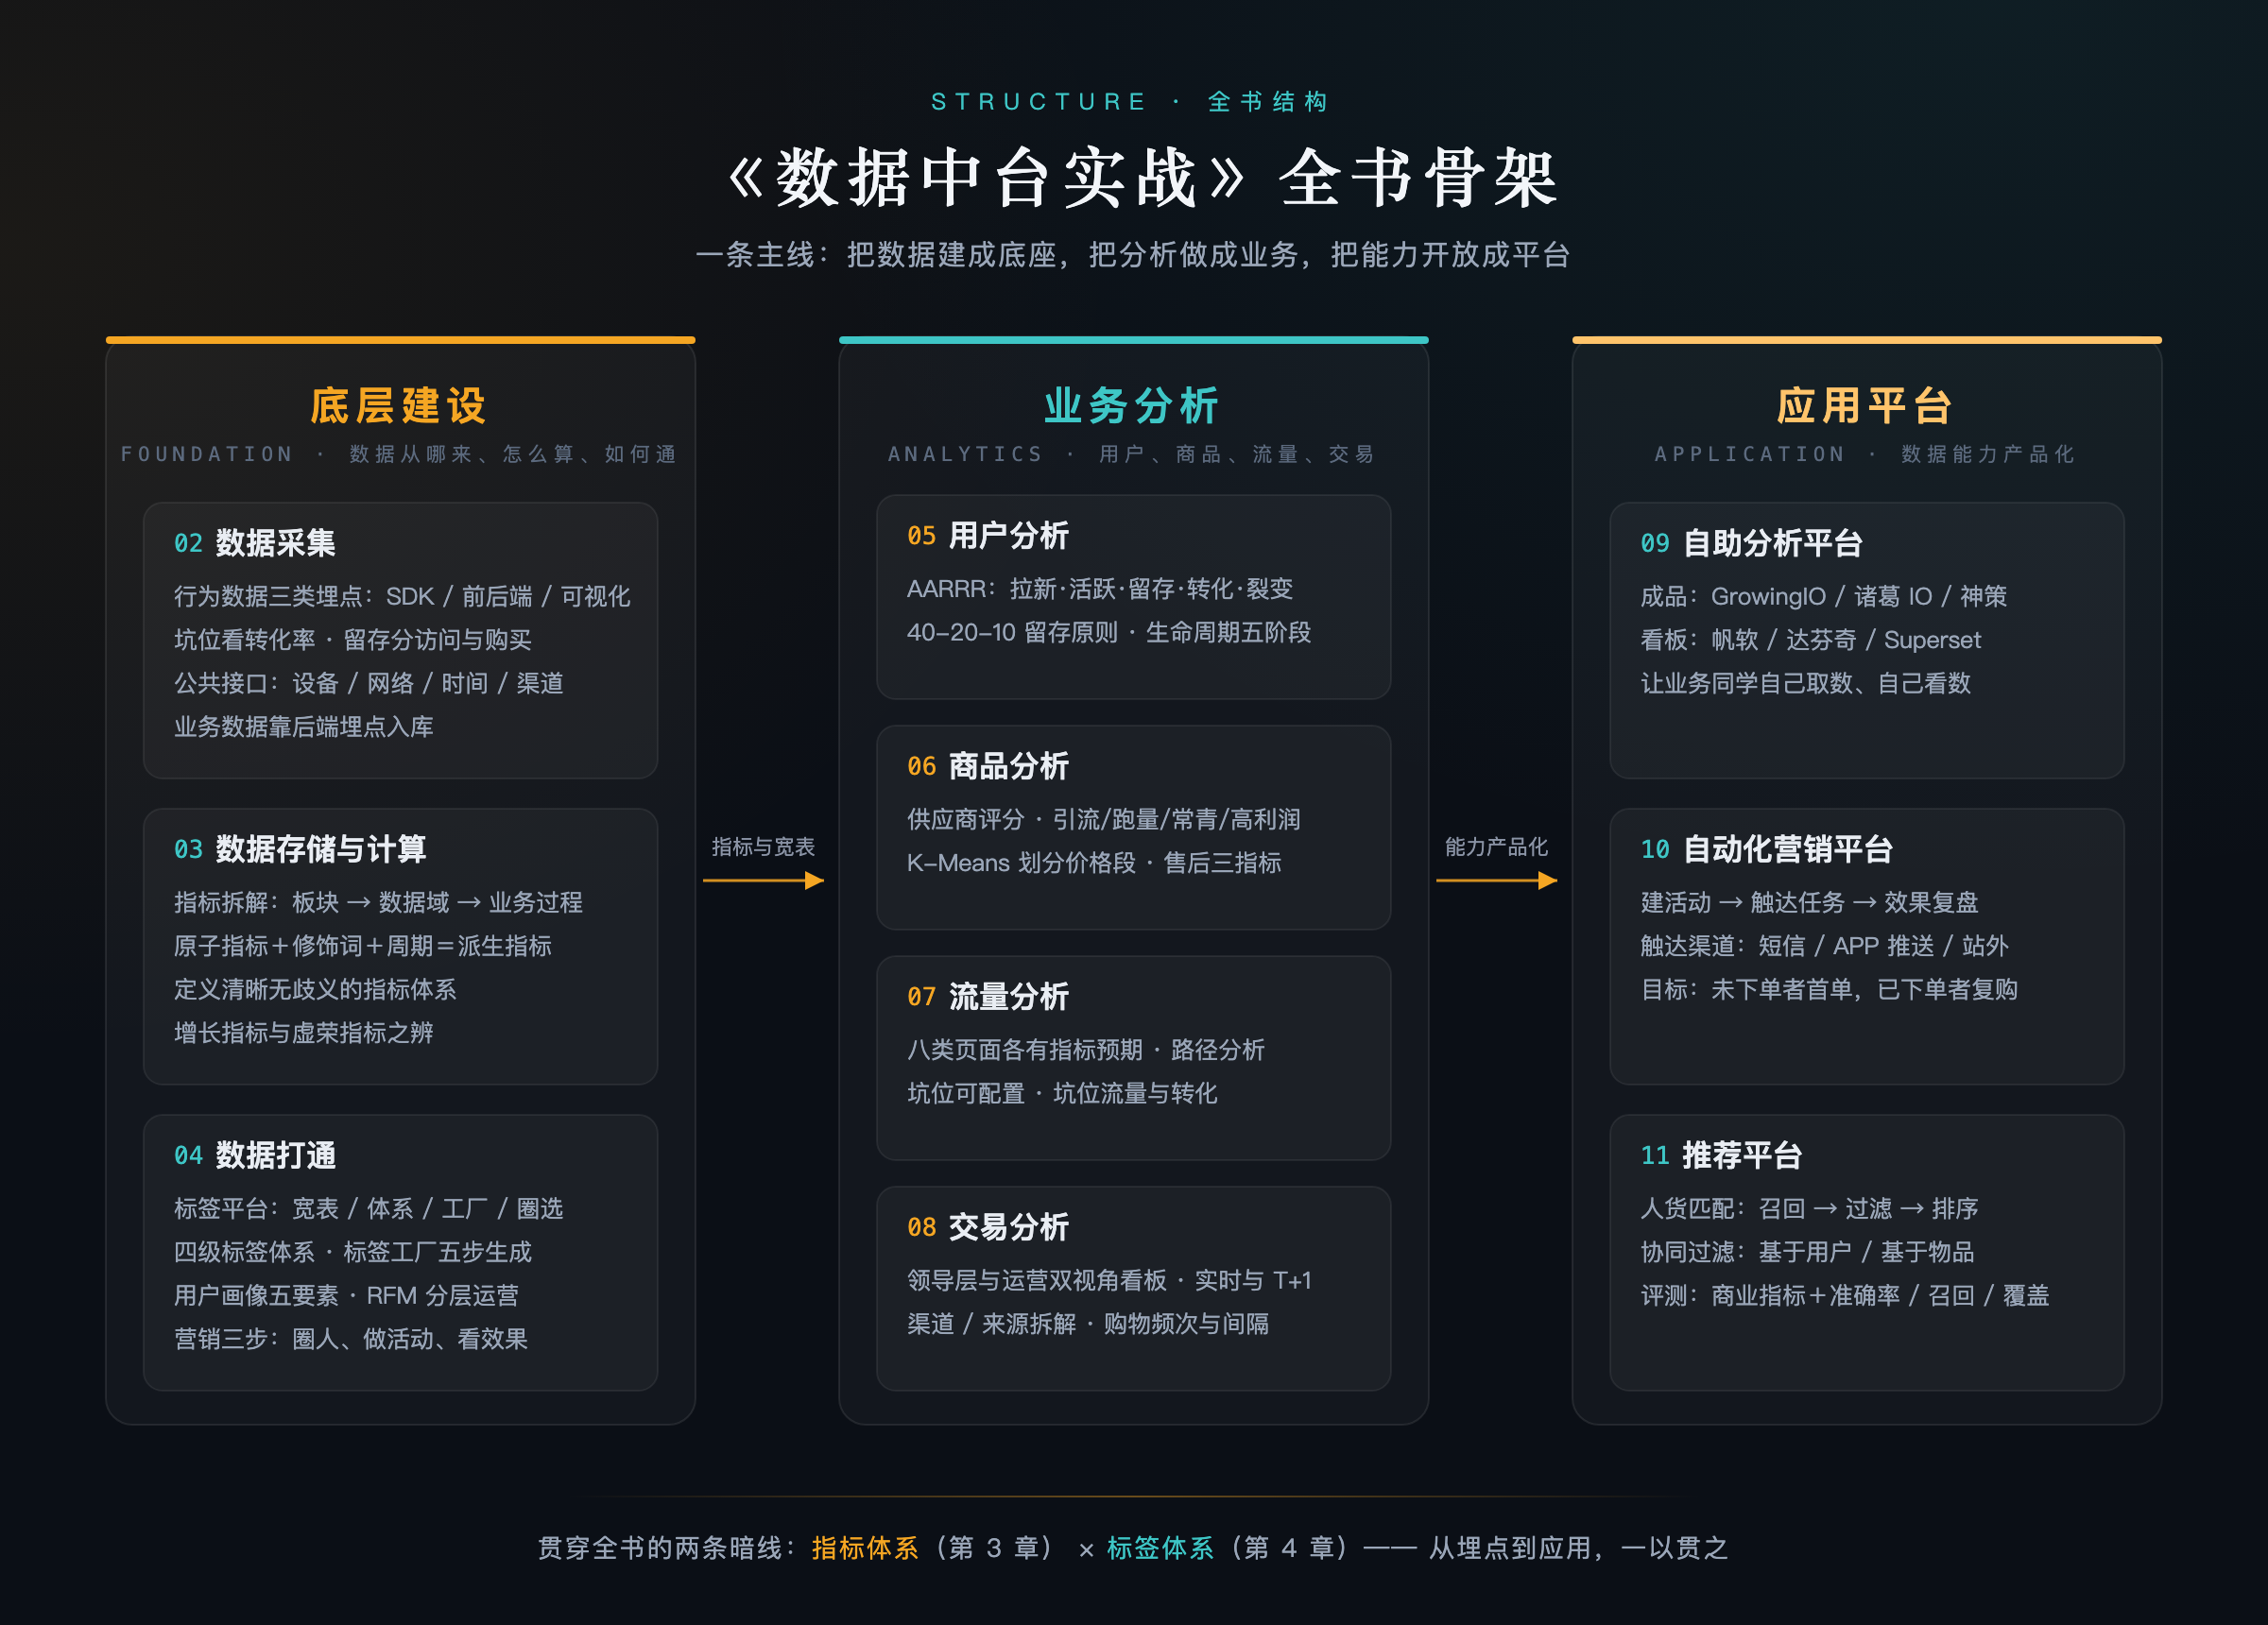
底层建设(2–4 章)→ 业务分析(5–8 章)→ 应用平台(9–11 章),指标体系与标签体系是贯穿全书的两条暗线。
第二章 数据采集
数据中台采集的数据分两类:用户行为数据与业务数据。用户访问、浏览商品属于行为数据;加购、下单、支付属于业务数据——两者的采集方式从一开始就分了岔。
用户行为数据的采集有三种方式:
- 与第三方移动应用统计公司合作完成采集;
- 采用前端与后端埋点结合的方式完成采集;
- 采用可视化埋点的方式完成采集——圈选界面即可定义事件,降低开发成本。
免费 SDK 可选项包括 Sensors Analytics、Mixpanel、Google Analytics。电商场景里,坑位只看 UV 是不够的,关键要看坑位转化率——访问坑位的用户中最终支付的比例。
留存情况从两个口径观察:访问留存(7 天、14 天后是否还来访问)与购买留存(7 天、14 天、30 天后是否还支付)。
采集要靠统一的公共接口约束字段:设备与浏览器信息(终端操作系统及版本、屏幕高宽、浏览器名称及版本)、SDK 信息(类型与版本号)、网络信息(IP、国家、省份、城市)、时间信息(服务端时间与客户端时间)、来源渠道,以及平台信息(产品线、客户端名称)。
页面浏览事件的核心字段:唯一标识(账号 / 设备 ID)、会员 ID(手机号)、页面名称、浏览时长、当前页面 URL、前向 URL、事件名称(浏览 / 点击)、事件类型(如收藏传 collect、加购物车传 addshop)、是否首次访问、是否首日访问。
商品详情页要追加一组特殊字段:坑位 ID、来源类型(活动 / 搜索 / 分类 / 推荐)、来源活动 ID、搜索条件、分类 ID、推荐场景 ID——没有这组字段,后面所有坑位分析和来源分析都无从谈起。
后端埋点负责业务数据:例如加入购物车时,把商品的来源信息以 JSON 形式记录入库,让每一单都能追溯到来路。
第三章 数据存储与计算
这一章的前提是:先定义清晰且没有歧义的数据指标。办法是拆解——把一个看似口语化的指标,拆成一组标准件。
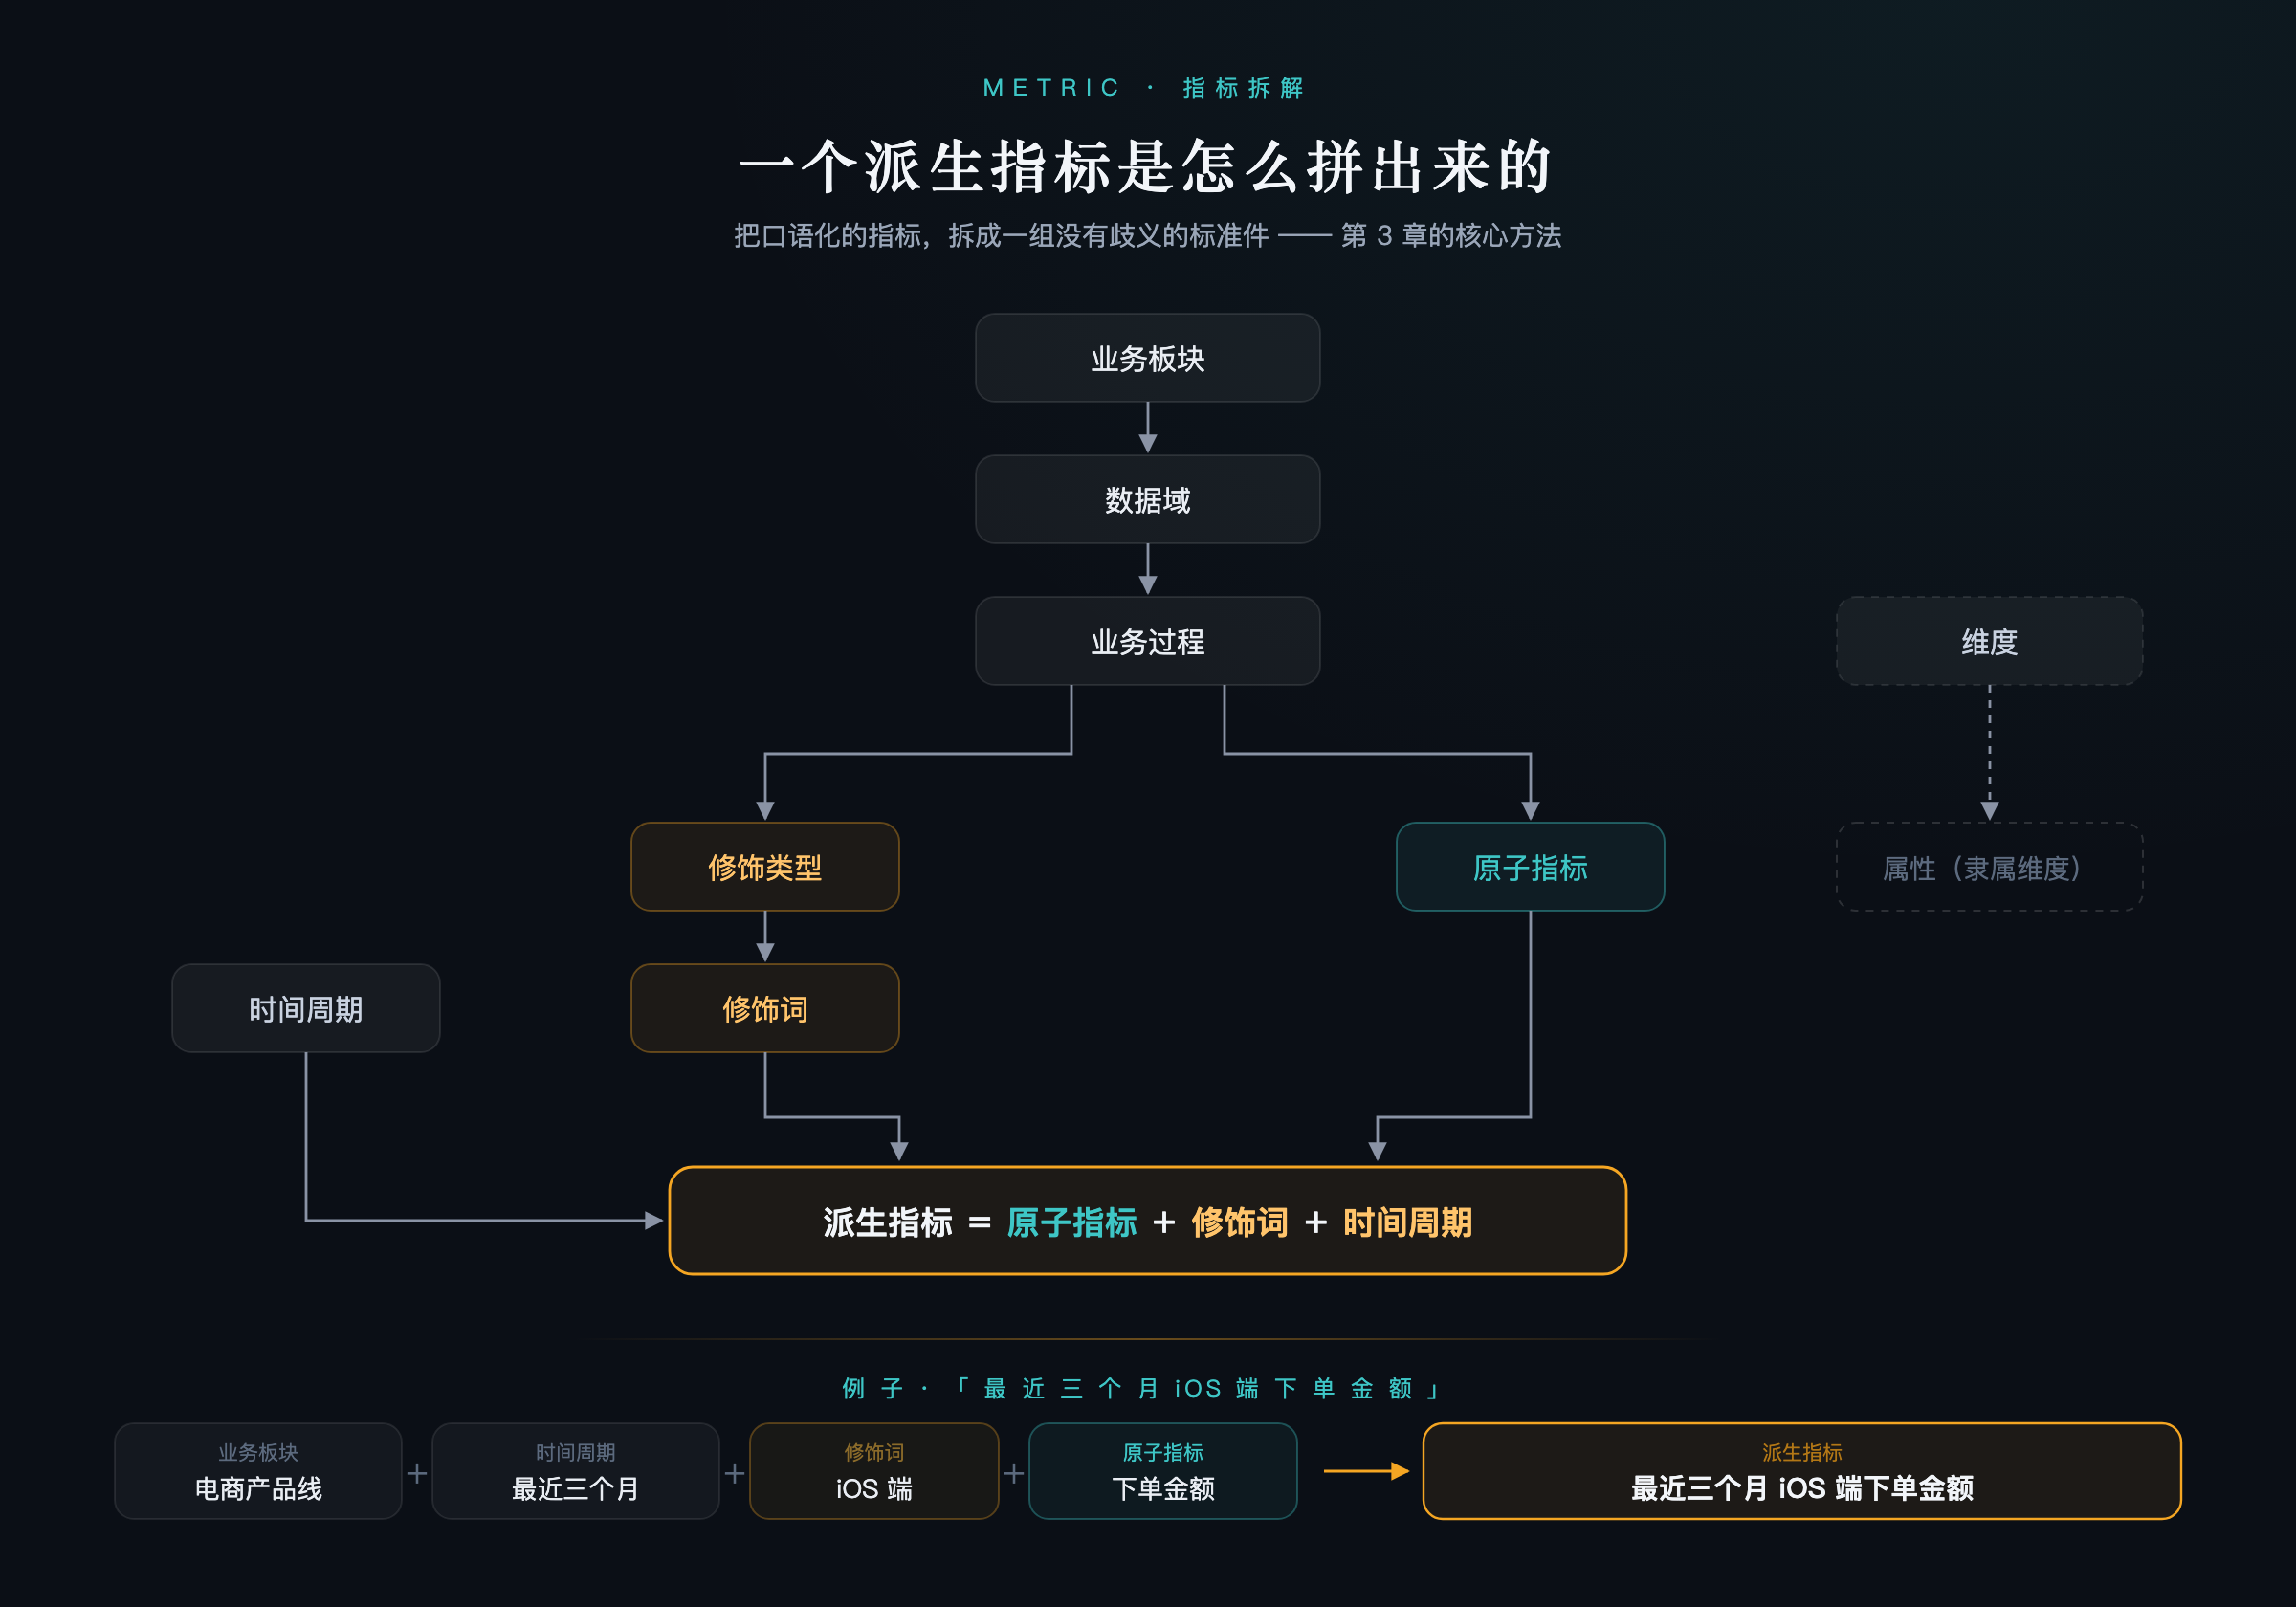
拆解涉及一组概念:业务板块即产品线;数据域是数据所属的领域;业务过程是完成某个业务所涉及的全部过程;时间周期是统计的时间范围;修饰类型是对修饰词的分类描述(如支付方式、终端类型);修饰词是维度以外的限定词;原子指标是不可再拆分的指标;维度是反映业务一类属性的度量单位;属性隶属于维度。而原子指标 + 修饰词 + 时间周期,就组成了一个派生指标。
书里给的例子一目了然——「最近三个月 iOS 端下单金额」:业务板块是电商产品线,业务过程是下单,修饰是客户端 iOS 端,时间周期是最近三个月,原子指标是下单金额——每个成分各就各位,指标便不再有歧义。
另一个判断标准同样实用:和公司的增长无关、且从中很难看出公司问题的指标是虚荣指标;能直接促进交易额的指标是增长指标。
第四章 数据打通
标签系统适合的场景是:有了一定的用户基础和数据积累,处于多条产品线、多种角色、数据分散度很高的状态——这正是中台要解决的「打通」问题。
标签平台有四个功能:
- 数据宽表:用来存储用户、商品等所有的指标,一张表看全一个对象;
- 标签体系:把各条产品线共用的标签和非共用的标签,按统一的层级结构组织起来;
- 标签工厂:基于规则选择指标、批量生成标签;
- 人群圈选:通过不同标签组合圈出人群,与推送、营销功能对接。
宽表是地基。用户宽表以手机号为主线,挂上国家、省份、城市、运营商、终端,以及 R(最近一次支付天数)、F(支付频次)、M(累计支付金额)等指标:
表 4-1 用户宽表的例子(节选)
| 平台名称 | 手机号 | 国家 | 省份 | 城市 | 运营商 | 终端 | R:最近一次支付天数 | F:支付频次 | M:累计支付金额 |
|---|---|---|---|---|---|---|---|---|---|
| 产品线 1 | 138xxxx | 中国 | xx | xx | 移动 | 安卓 | 12 | 16 | 5673 元 |
| 产品线 1 | 138xxxx | 中国 | xx | xx | 联通 | iOS | 9 | 7 | 721 元 |
| 产品线 1 | 138xxxx | 中国 | xx | xx | 移动 | 安卓 | 8 | 3 | 64 元 |
| 产品线 1 | 138xxxx | 中国 | xx | xx | 联通 | iOS | 1 | 22 | 8999 元 |
商品宽表同理,围绕商品名称挂上架状态、面料、价格、风格、店铺、品牌、销售热度:
表 4-2 商品宽表的例子
| 商品名称 | 上架状态 | 面料 | 价格 | 风格 | 店铺 | 品牌 | 销售热度 |
|---|---|---|---|---|---|---|---|
| 商品 1 | 上架 | xx | 56 元 | 甜美 | xx | xx | 7884 |
| 商品 2 | 上架 | xx | 78 元 | 甜美 | xx | xx | 674 |
| 商品 3 | 上架 | xx | 77 元 | 甜美 | xx | xx | 889 |
| 商品 4 | 上架 | xx | 169 元 | 甜美 | xx | xx | 622 |
标签体系采用四级结构。基础标签挂在「基本信息」之下,如平台信息、用户类型、潜客、地理位置,多数为事实标签,潜客类型这类需要模型判别的是模型标签:
表 4-3 标签体系的基础标签例子(节选)
| 一级标签 | 二级标签 | 三级标签 | 四级标签 | 标签规则 | 标签类型 |
|---|---|---|---|---|---|
| 基本信息 | 平台信息 | 平台类型 | 产品线 A – F | — | 事实标签 |
| 基本信息 | 用户类型 | 采购端 / 供应端 | 角色 A / 角色 B | — | 事实标签 |
| 基本信息 | 潜客 | 是否潜客 | 是 | 只存在于 CRM 库中 | 事实标签 |
| 基本信息 | 潜客 | 是否潜客 | 已入库 | 同时存在于业务库和 CRM 库中 | 事实标签 |
| 基本信息 | 潜客 | 潜客类型 | 销售线索 / 商机鉴别 / 商务谈判 / 签约下单 | — | 模型标签 |
| 基本信息 | 地理位置 | 国家 | 中国 / 美国 / 广东省…… | — | 事实标签 |
业务标签则按产品线挂「用户价值」,把 R、F、M 分段做成模型标签(产品线 B 与 A 同构):
表 4-4 标签体系的业务标签例子
| 一级标签 | 二级标签 | 三级标签 | 四级标签 | 标签类型 |
|---|---|---|---|---|
| 产品线 A | 用户价值 | 距上次支付天数(R) | R<15 / 15≤R≤45 / R>45 / 空值 | 模型标签 |
| 产品线 A | 用户价值 | 支付次数(F) | F>2 / F=2 / F=1 / F=0 | 模型标签 |
| 产品线 A | 用户价值 | 支付金额 M(元) | M<2000 / 2000≤M≤6000 / M>6000 / 空值 | 模型标签 |
标签工厂生成标签的五步:选择平台 → 选择维度 → 选择一级标签和二级标签 → 定义标签 → 设定标签的计算规则。界面上就是选指标、配运算符——比如给「用户价值」挂两个标签:「注册天数 ≤ 2」「消费频次 < 2 次」,二者用「且」「或」组合,就能描述一群人。
人群圈选有三种方式:基于用户的客观属性标签、基于用户行为、基于用户的主观标签(由运营、销售手动打标,支持单个或批量,可管理有效性、是否停用与有效期)。
用户画像由五块拼成:基础信息、关键指标(加购 / 收藏 / 领券 / 下单)、标签信息、访问路径信息、偏好信息。
RFM 模型是其中最经典的分层:R(Recency)是用户最近一次交易时间的间隔,F(Frequency)是一段时间内交易的次数,M(Monetary)是一段时间内交易的金额。
营销活动一般分三步:圈人、做活动、看效果——标签平台是第一步的地基。
第五章 用户分析
用户分析的总纲是 AARRR 理论:拉新(获取)、活跃(激活)、留存、转化(收入)、裂变(推荐),五个环节构成一条漏斗。
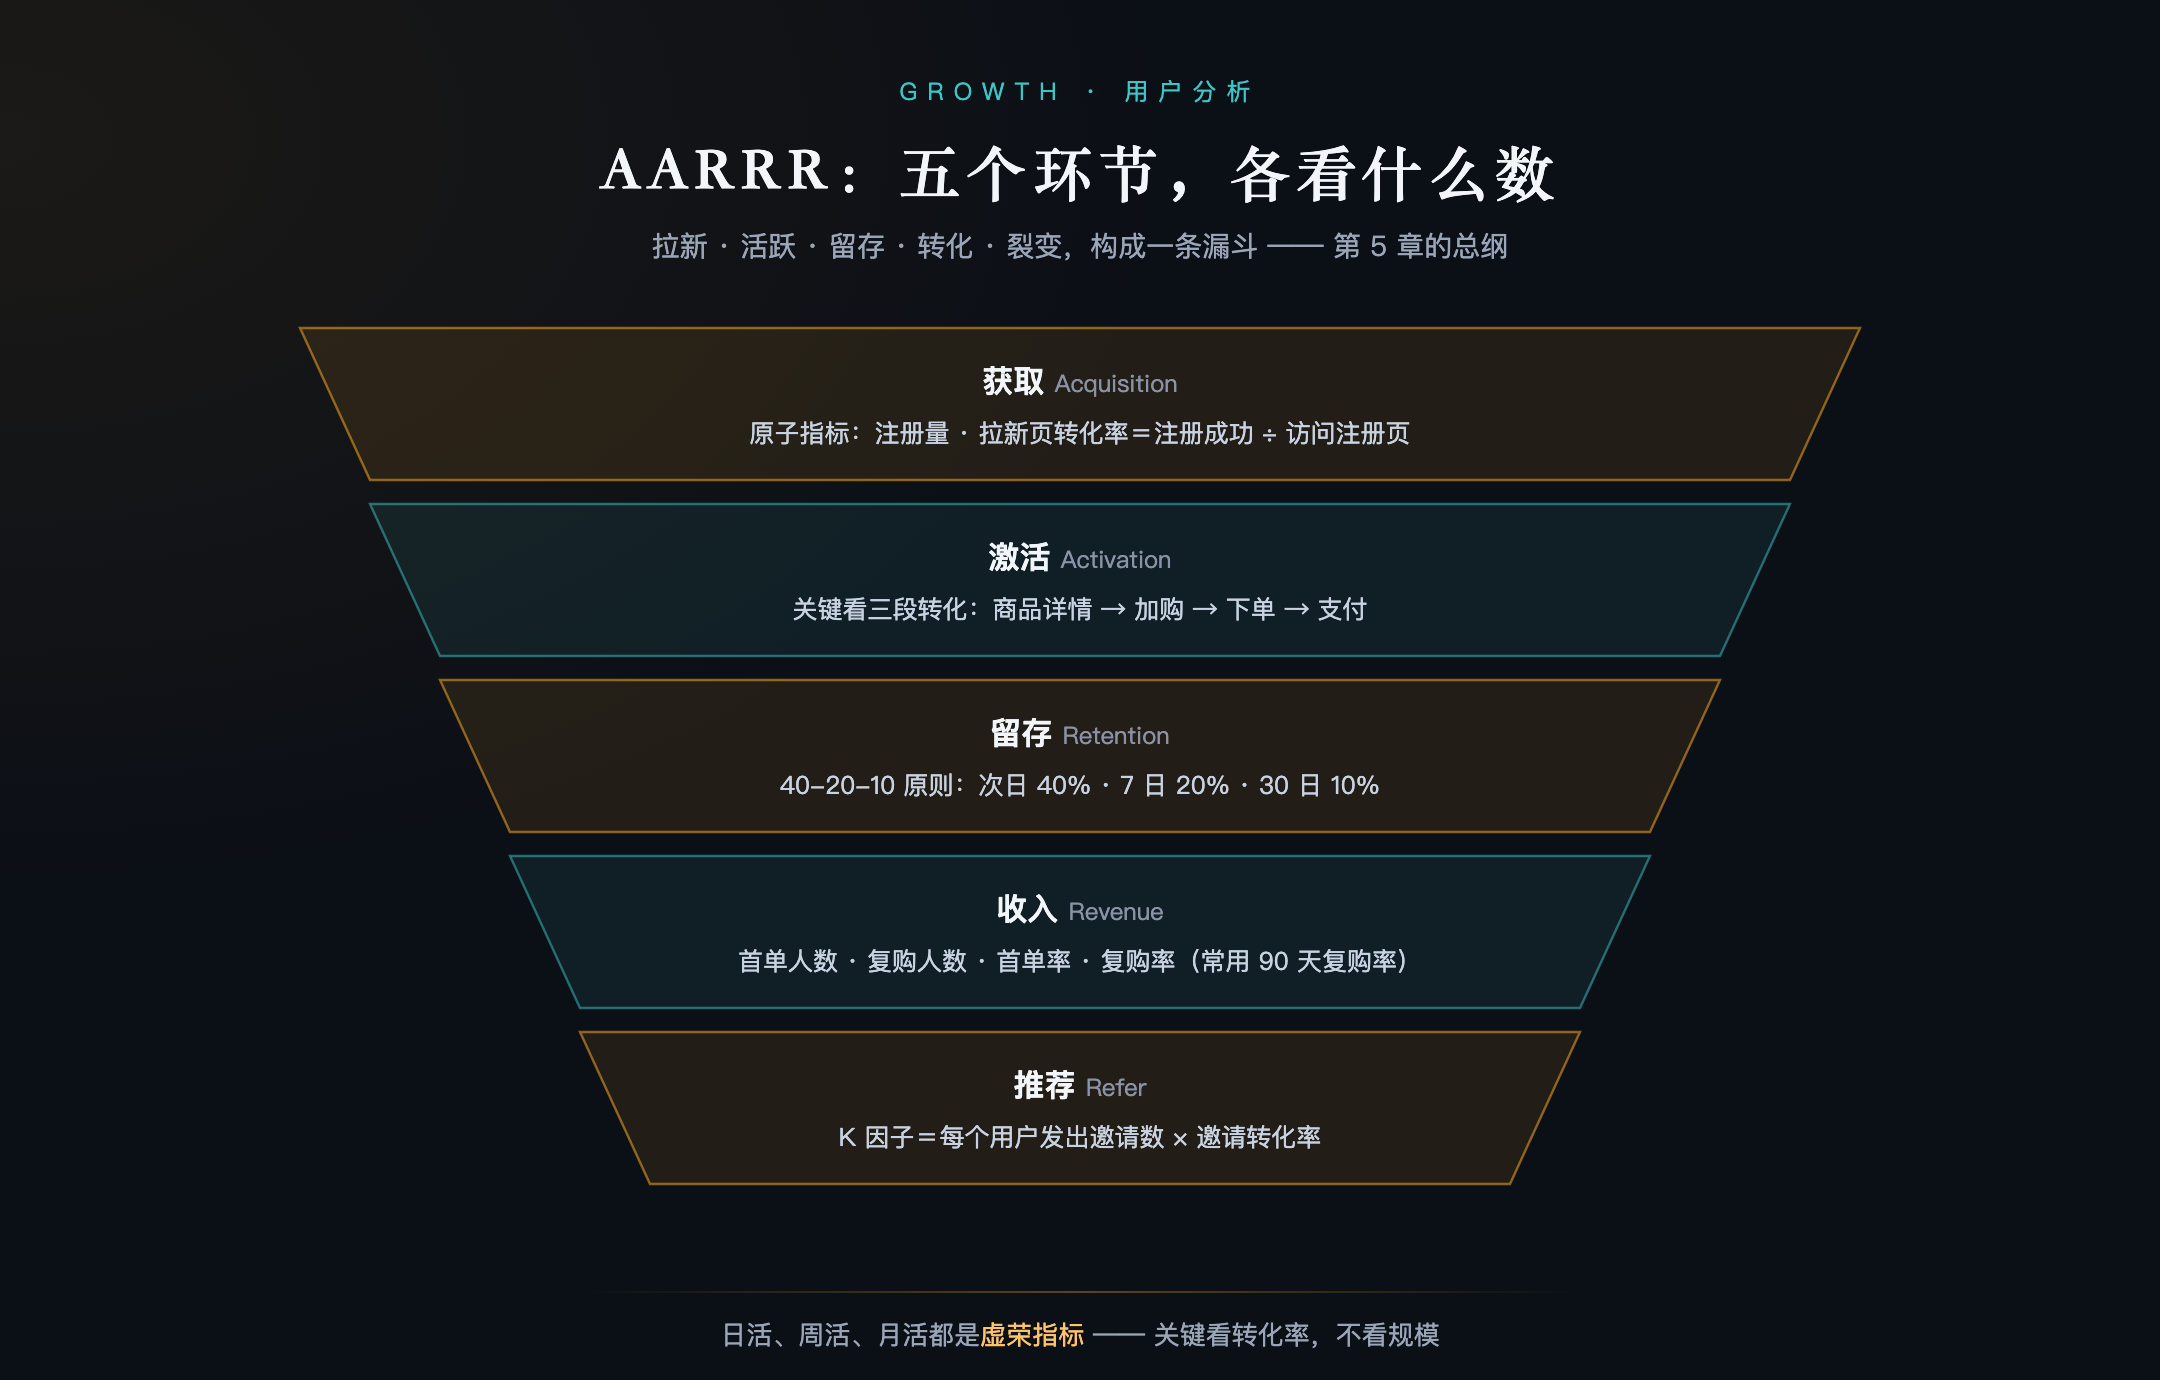
用户拉新的原子指标是注册量。渠道管理分三级:一级是部门,二级是大类(SEM、地推等),三级是渠道拉新的更细分类别。拉新页面转化率 = 注册成功人数 ÷ 访问注册页人数。
用户活跃分析里,日活、周活、月活都是虚荣指标;关键指标是三段转化率:访问商品详情 → 加购、加购 → 下单、下单 → 支付。
用户留存分析记住一个基准:40-20-10 原则——次日留存 40%,7 日留存 20%,30 日留存 10%。口径分访问留存率与购买留存率。
用户转化分析的关键指标:首单人数、复购人数、首单率、复购率,常用 90 天复购率。
用户裂变分析的核心是 K 因子:每个用户发出邀请数量 × 接到邀请转化为新用户的转化率。
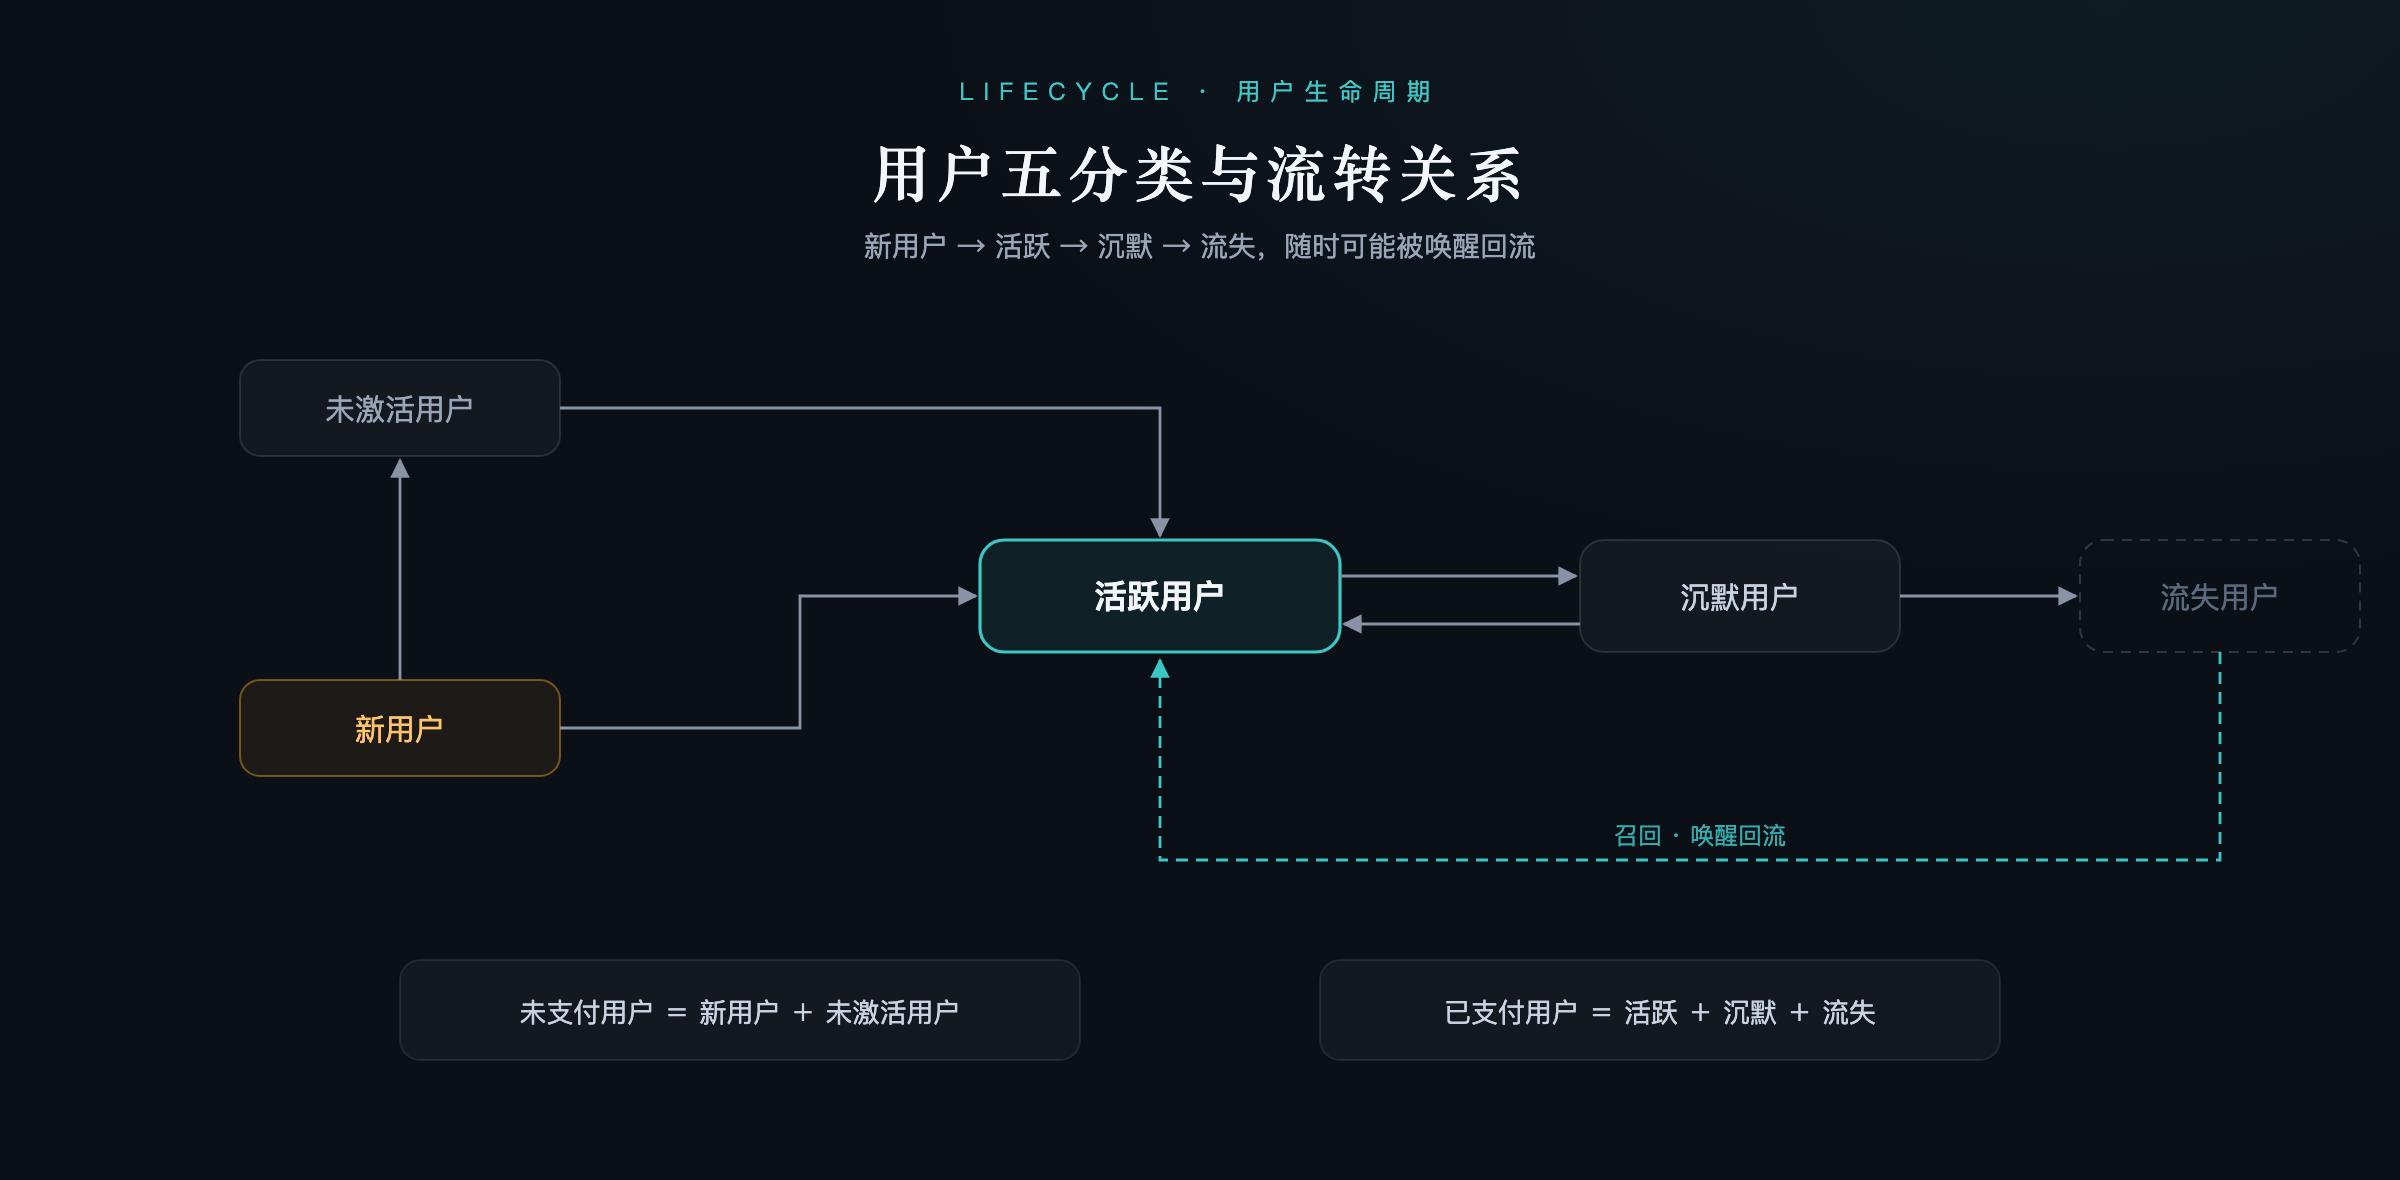
用户生命周期把用户分成新用户、未激活用户、活跃用户、沉默用户、流失用户五类,彼此之间可以流转——未激活可以被唤醒为活跃,活跃与沉默互有来往,流失也有回流的机会。换算关系是:未支付用户 = 新用户 + 未激活用户;已支付用户 = 活跃用户 + 沉默用户 + 流失用户。
第六章 商品分析
供应商选择的评分标准:商品销售数量、发货速率、次品率。商品定位是市场定位问题;商品数量规划分四款:引流款、跑量款、四季常青款、高利润款。
商品售中分析的常用指标:商品 PV、商品 UV、支付件数、支付金额、转化率。价格段管理可以自动化——用 K-Means 聚类算法把每个品类划分出最合适的价格段:先找到每个品类价格的中心点,再通过中心点划分价格段。落地时注意三点:剔除异常值、设定定时器定期调整、划分好后找运营人员讨论。
售后分析看三个指标:次品率、48 小时发货率、退货率。
第七章 流量分析
网页分八类,各自的指标预期不同:推广落地页(访问时长要短,快进快出才算精准)、首页、商品列表页、商品详情页(访问时间要长、跳出率要低)、加购页、下单页、支付页、个人中心页。
路径分析基于汇总数据与明细数据,还原用户在页面间的游走路线。
坑位流量分析是电商特有的视角:坑位由各产品线负责开发控制,管理上要做成可配置(背景图、标题、内容等),支持开启和禁用。基础指标:PV、UV、坑位交易额、下单人数、转化率。有一个口径问题必须先明确:坑位的流量是否包含坑位内层页面产生的流量。
第八章 交易分析
交易分析要分视角设计。针对公司领导层:交易额、公司总用户数、收入,数据模式分实时与 T+1(数据晚一天)。针对产品与运营人员:年度目标和完成率、月度目标和完成率、每日交易额、每日收入。
再往下钻两个维度:渠道交易分析区分线上销售渠道与线下销售渠道;交易来源分析按客户端、坑位、分类页、推荐等拆分——依赖前端埋点与后端埋点的配合。最后还有两组行为视角:购物频次分析与购物间隔分析。
第九章 自助分析平台
自助分析的思路是把取数、看数的能力开放给业务同学。市面成品:GrowingIO、诸葛 IO、神策;看板工具:帆软、达芬奇自助看板、Superset。
第十章 自动化营销平台
自动化营销平台把「圈人、做活动、看效果」三步产品化。活动策划先明确活动目的;圈人用标签平台定义目标用户;做活动确定内容并选择渠道(消息中心);看效果用数据体现活动效果。
平台功能三件套:
- 建活动:主题、产品线、归类;
- 触达任务:一个活动对应一个或多个触达任务;
- 任务设置:类型、时间、渠道——短信 / APP 推送 / 站外推送。
常规活动内容:优惠券(类型、使用条件)、H5 小游戏(基本信息、页面、文案,以及时间、奖品等细节信息)、H5 页面。活动效果分析依托带链接的短信与 H5 小游戏回传数据;复盘看两个数:新增用户数、活动交易额。活动的目标始终是:没下过单的人首次下单,下过单的人复购。
第十一章 推荐平台
推荐系统的价值是解决人货匹配的问题。用户数据分显性数据与隐性数据(即用户行为数据)。
功能上分三步:召回——通过一定方式找到用户可能感兴趣的商品(与用户喜欢物品类似的物品、与用户有相似兴趣的用户喜欢的物品、基于用户标签推荐的物品);过滤——剔除不该出现的商品;排序——把最可能成交的排到前面。
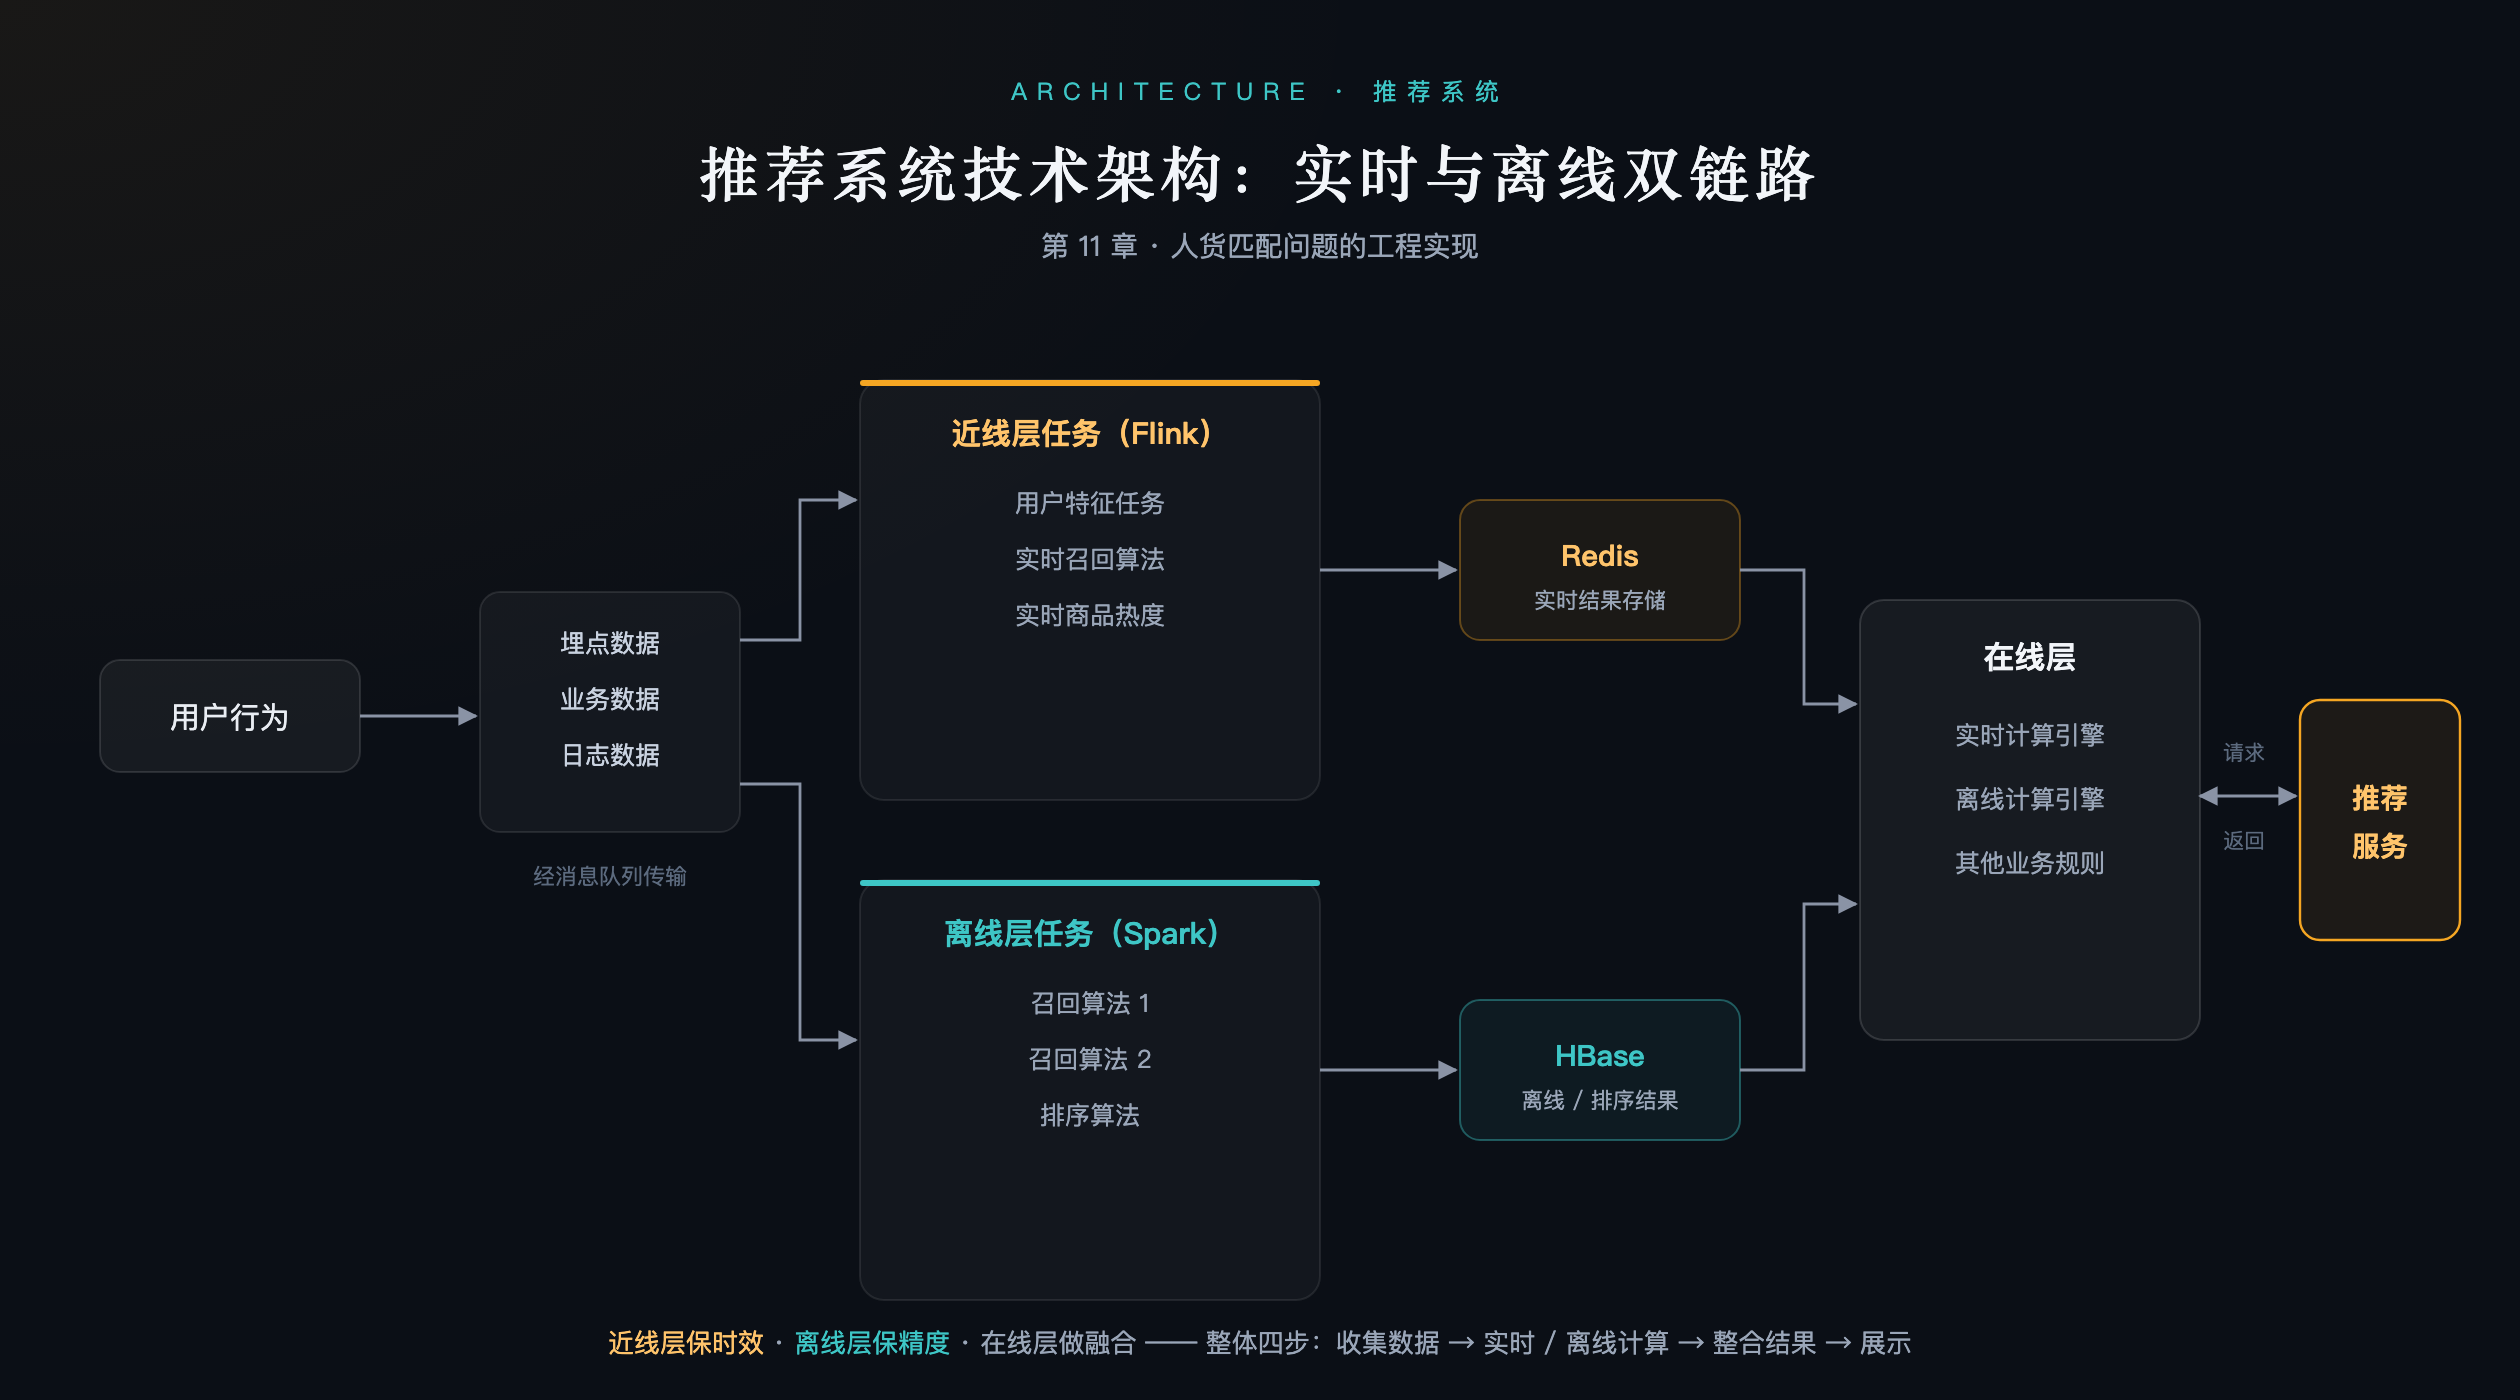
技术架构上,数据流是:用户行为产生埋点数据、业务数据、日志数据,经消息队列传输;近线层任务(如 Flink)负责用户特征、实时召回算法、实时商品热度,结果存入 Redis;离线层任务(如 Spark)跑召回算法与排序算法,结果存入 HBase;在线层整合实时计算引擎、离线计算引擎与其他业务规则,响应推荐请求。整体流程四步:收集用户产生的数据 → 执行实时层、离线层的计算任务 → 整合实时推荐结果和离线推荐结果 → 展示推荐结果。
经典推荐算法有两族。基于用户的协同过滤:先找到和目标用户兴趣相似的用户,再把相似用户喜欢、且目标用户没买过的商品推出去。基于物品的协同过滤:先找到目标用户曾经可能喜欢的物品,计算物品相似度,将相似度最高的物品推荐给用户。
评测分两套指标:商业指标——曝光次数、商品 PV、UV、支付人数、支付金额、支付件数、点击率、支付转化率;算法运行监测指标——准确率、召回率、覆盖率。
读完全书回头看,数据中台并不是一个买来的系统,而是从埋点规范、指标定义这些最不起眼的工序里一层层长出来的:采集决定数据全不全,指标体系决定数据清不清,标签体系决定用户连不连得起来;在此之上,用户、商品、流量、交易四个分析场景各自回答一个业务问题;最后,自助分析把能力交给分析师,自动化营销把人群交给运营,推荐把人货匹配交给算法。所谓中台,就是让每一次圈人、每一次复盘、每一次推荐,都有数可依。
指标口径是数据中台的第一生产力——埋点采不全,后面全白算;指标说不清,报表全白做。——读《数据中台实战》后记
评论 (0)
还没有评论,来抢沙发。