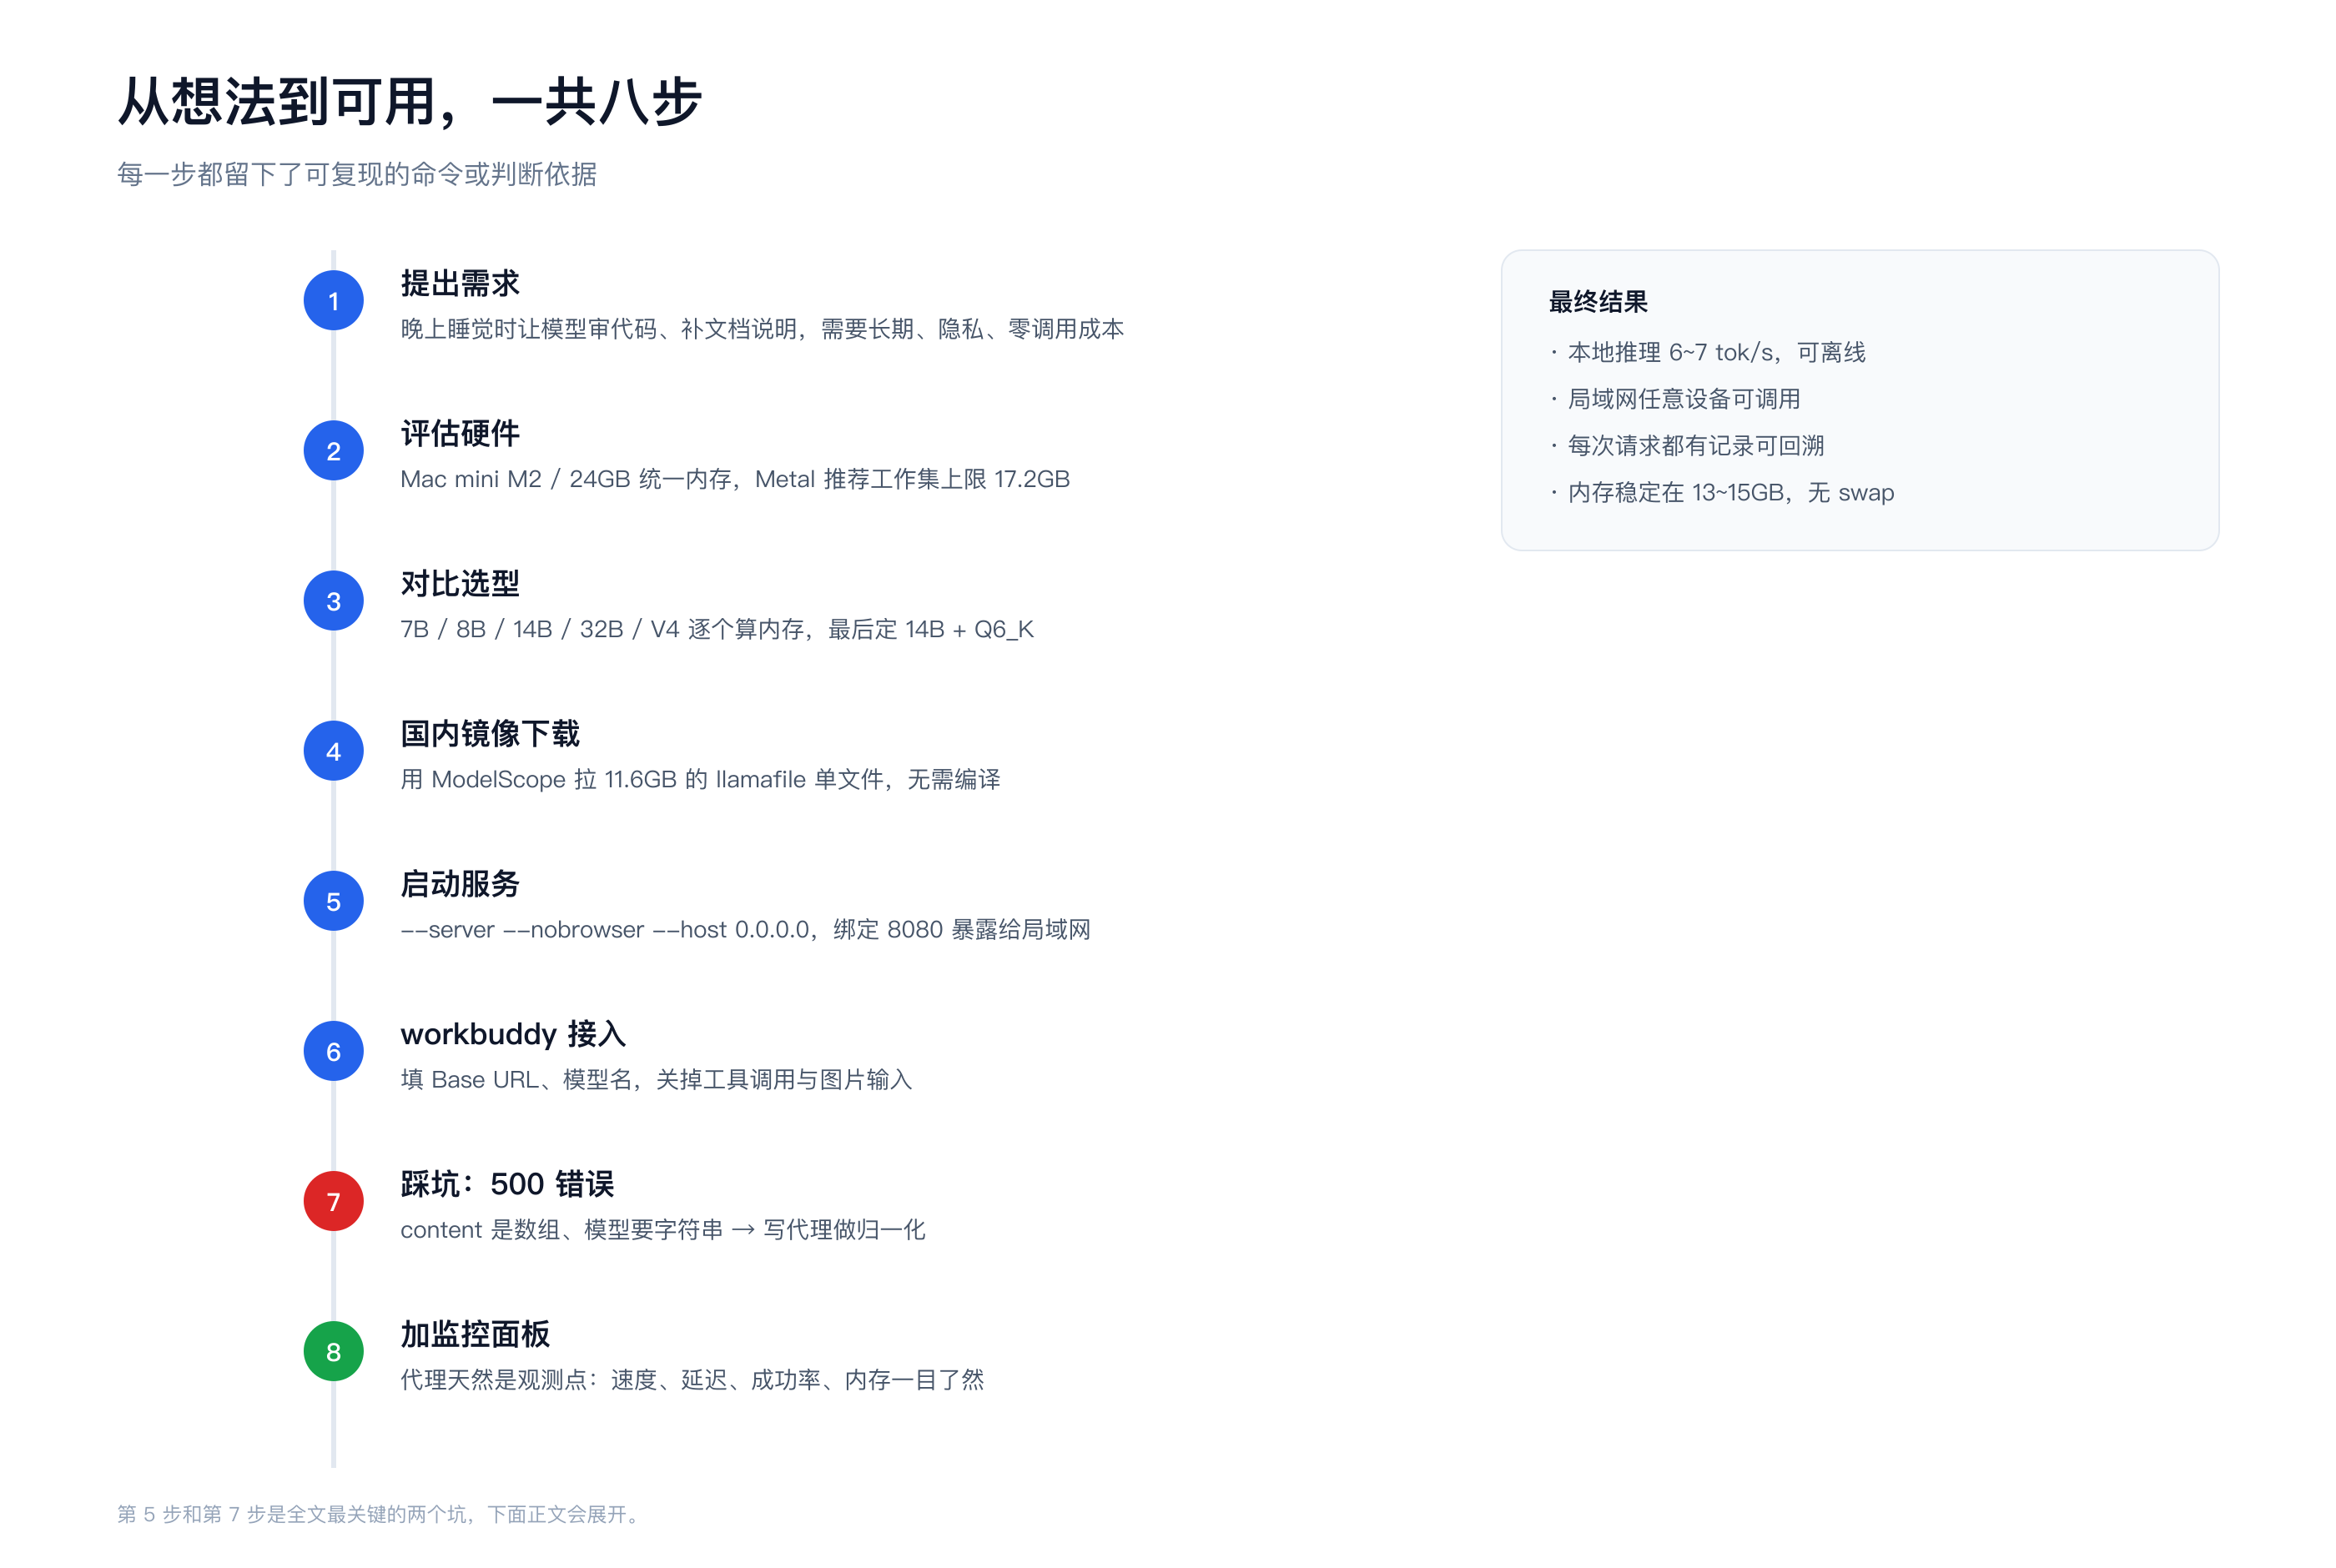
摘要
我用一台 Mac mini M2 / 24GB 在本机跑起了 DeepSeek-R1-Distill-Qwen-14B(Q6_K 量化),通过一个自己写的 Python 代理把它暴露成 OpenAI 兼容 API,局域网里的 workbuddy 可以直接调用,并且配了一个实时监控面板看速度、延迟、成功率和内存。
整件事的实测结果:
| 指标 | 实测值 |
|---|---|
| 生成速度 | 6.4 ~ 6.7 token/s |
| 一次 600 token 的回复 | 约 69 ~ 91 秒 |
| 系统内存占用 | 14.6 ~ 15.2 GB / 24 GB |
| 模型权重文件 | 11.58 GB |
| 8K 上下文的 KV Cache | 1536 MiB |
| 请求成功率 | 100%(4 次真实调用) |
下面把整个过程按时间顺序拆开写:为什么做、能不能做、选什么、怎么装、怎么接、踩了什么坑、为什么还要加监控。
起因:我要它干什么
需求很具体,不是"我想玩大模型",而是:
- 晚上睡觉的时候,让它跑代码审查:白天写的东西来不及细看,希望夜里能扫一遍,把明显的问题列出来。
- 补文档说明:很多模块缺注释、缺 README,希望它能按代码生成初稿。
- 做对比分析:同一个问题的几种方案,让它给出差异点。
这几个需求共同指向三个约束:
- 要能长时间跑:不是问一句答一句,而是挂机跑批量任务。
- 数据不能出本机:代码是私有资产,走云端 API 等于把源码交出去。
- 成本要可控:批量审代码的 token 消耗很大,按量计费不划算。
这三条加起来,答案就是本地部署。剩下的问题只有一个:这台机器扛不扛得住。
第一步:老机器到底能不能扛
2.1 先看硬件底子
sysctl -n hw.model        # Mac14,3
sysctl -n hw.memsize      # 25769803776  → 24GB
sw_vers -productVersion   # 14.8.5
system_profiler SPHardwareDataType | grep -E "Chip|Memory|Cores"
结果:
Chip: Apple M2
Total Number of Cores: 8 (4 performance and 4 efficiency)
Memory: 24 GB
M2 不是"老掉牙",但也不是性能怪兽。它的关键优势是统一内存架构:CPU 和 GPU 共享同一块内存,模型权重不需要在显存和内存之间搬运。对跑大模型来说,这比"CPU 强但显存小"的机器友好得多。
2.2 三个真正的约束
判断能不能跑,不能只看"内存够不够",要看三件事:
| 约束 | 说明 | 这台机器的情况 |
|---|---|---|
| 内存容量 | 权重 + KV Cache + 系统开销要一起装下 | 24GB,扣掉系统还剩约 18~19GB |
| 内存带宽 | 决定 token 生成速度的上限 | M2 约 100GB/s,14B Q6_K 理论上限约 8~9 tok/s |
| 算力 | 决定 prompt 处理速度 | 8 核 + Metal,够用但不出彩 |
这里有个实测数据很关键。启动模型时,llamafile 会打印 Metal 的推荐工作集上限:
ggml_metal_init: recommendedMaxWorkingSetSize = 17179.89 MB
也就是说,24GB 的机器,Metal 建议单个进程最多用约 17.2GB。这就是真正的天花板,不是 24GB。
2.3 内存账本
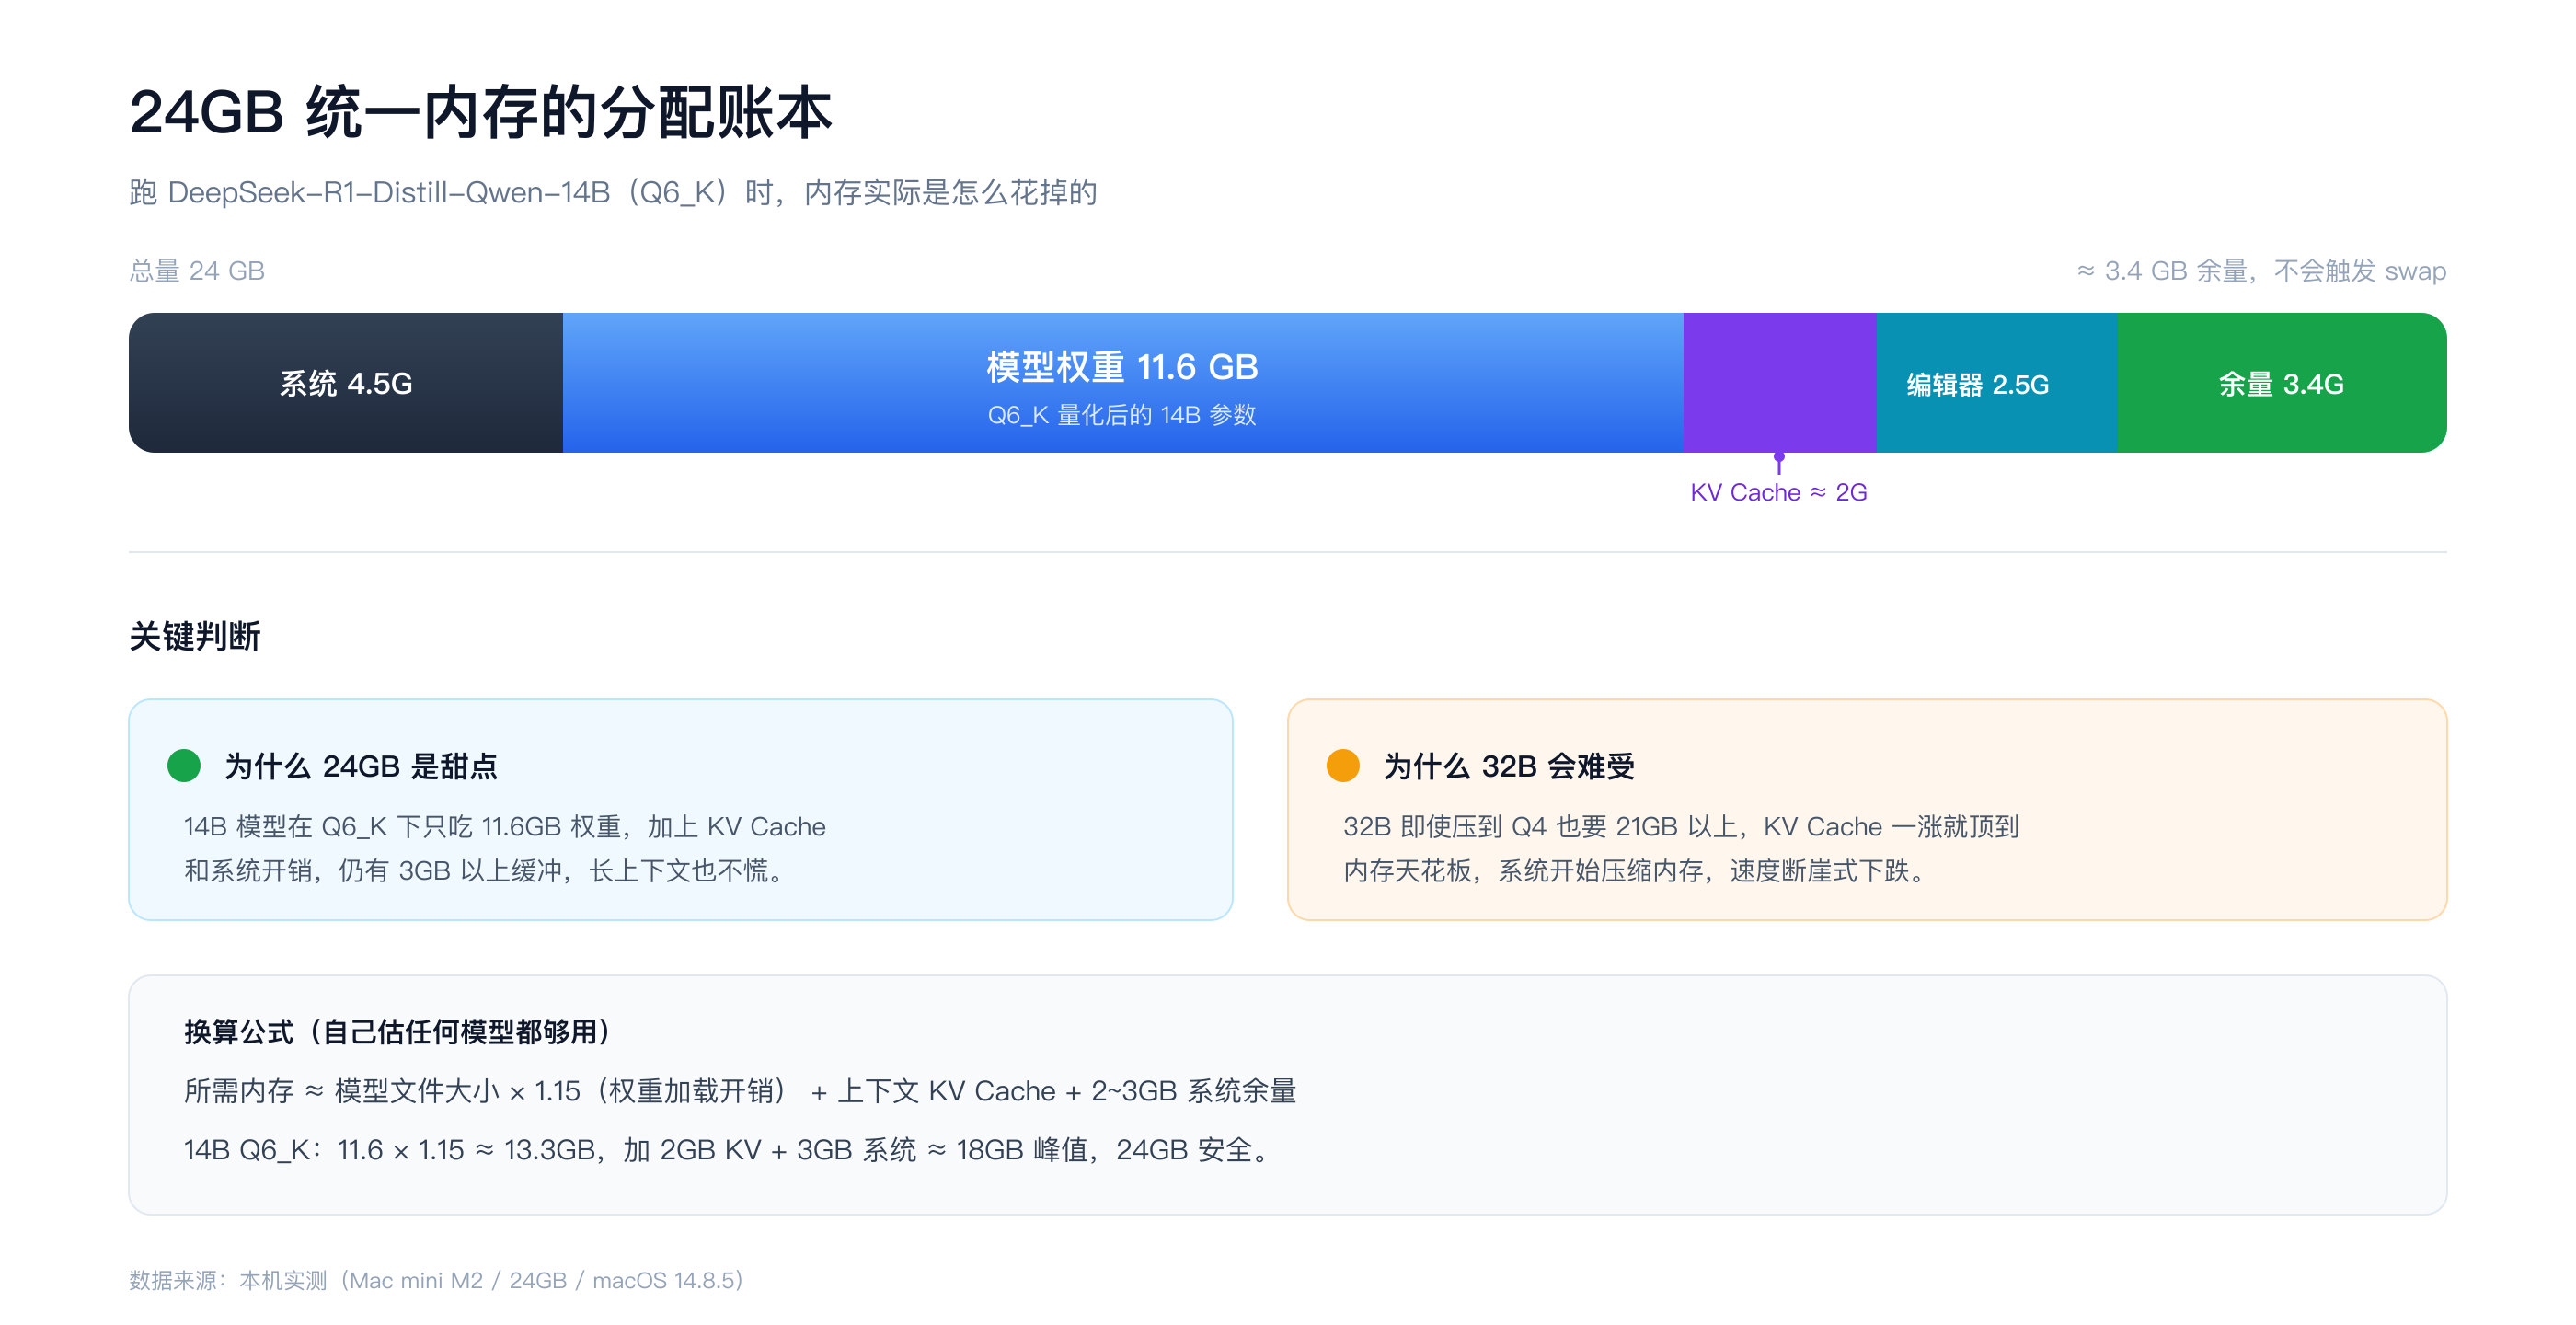
跑 14B Q6_K 时,内存大致这样分配:
- 模型权重:11.6GB(GGUF 文件 mmap 进内存)
- KV Cache:约 2GB(8K 上下文,实测 1536 MiB)
- 系统与后台:约 4.5GB
- 编辑器/浏览器:约 2.5GB
- 余量:约 3.4GB
估算公式,以后换任何模型都能用:
所需内存 ≈ 模型文件大小 × 1.15(加载开销) + KV Cache + 2~3GB 系统余量
代入 14B Q6_K:11.6 × 1.15 ≈ 13.3GB,加 2GB KV、3GB 系统,峰值约 18GB。24GB 有安全余量,结论是能跑。
2.4 哪些能跑,哪些别想
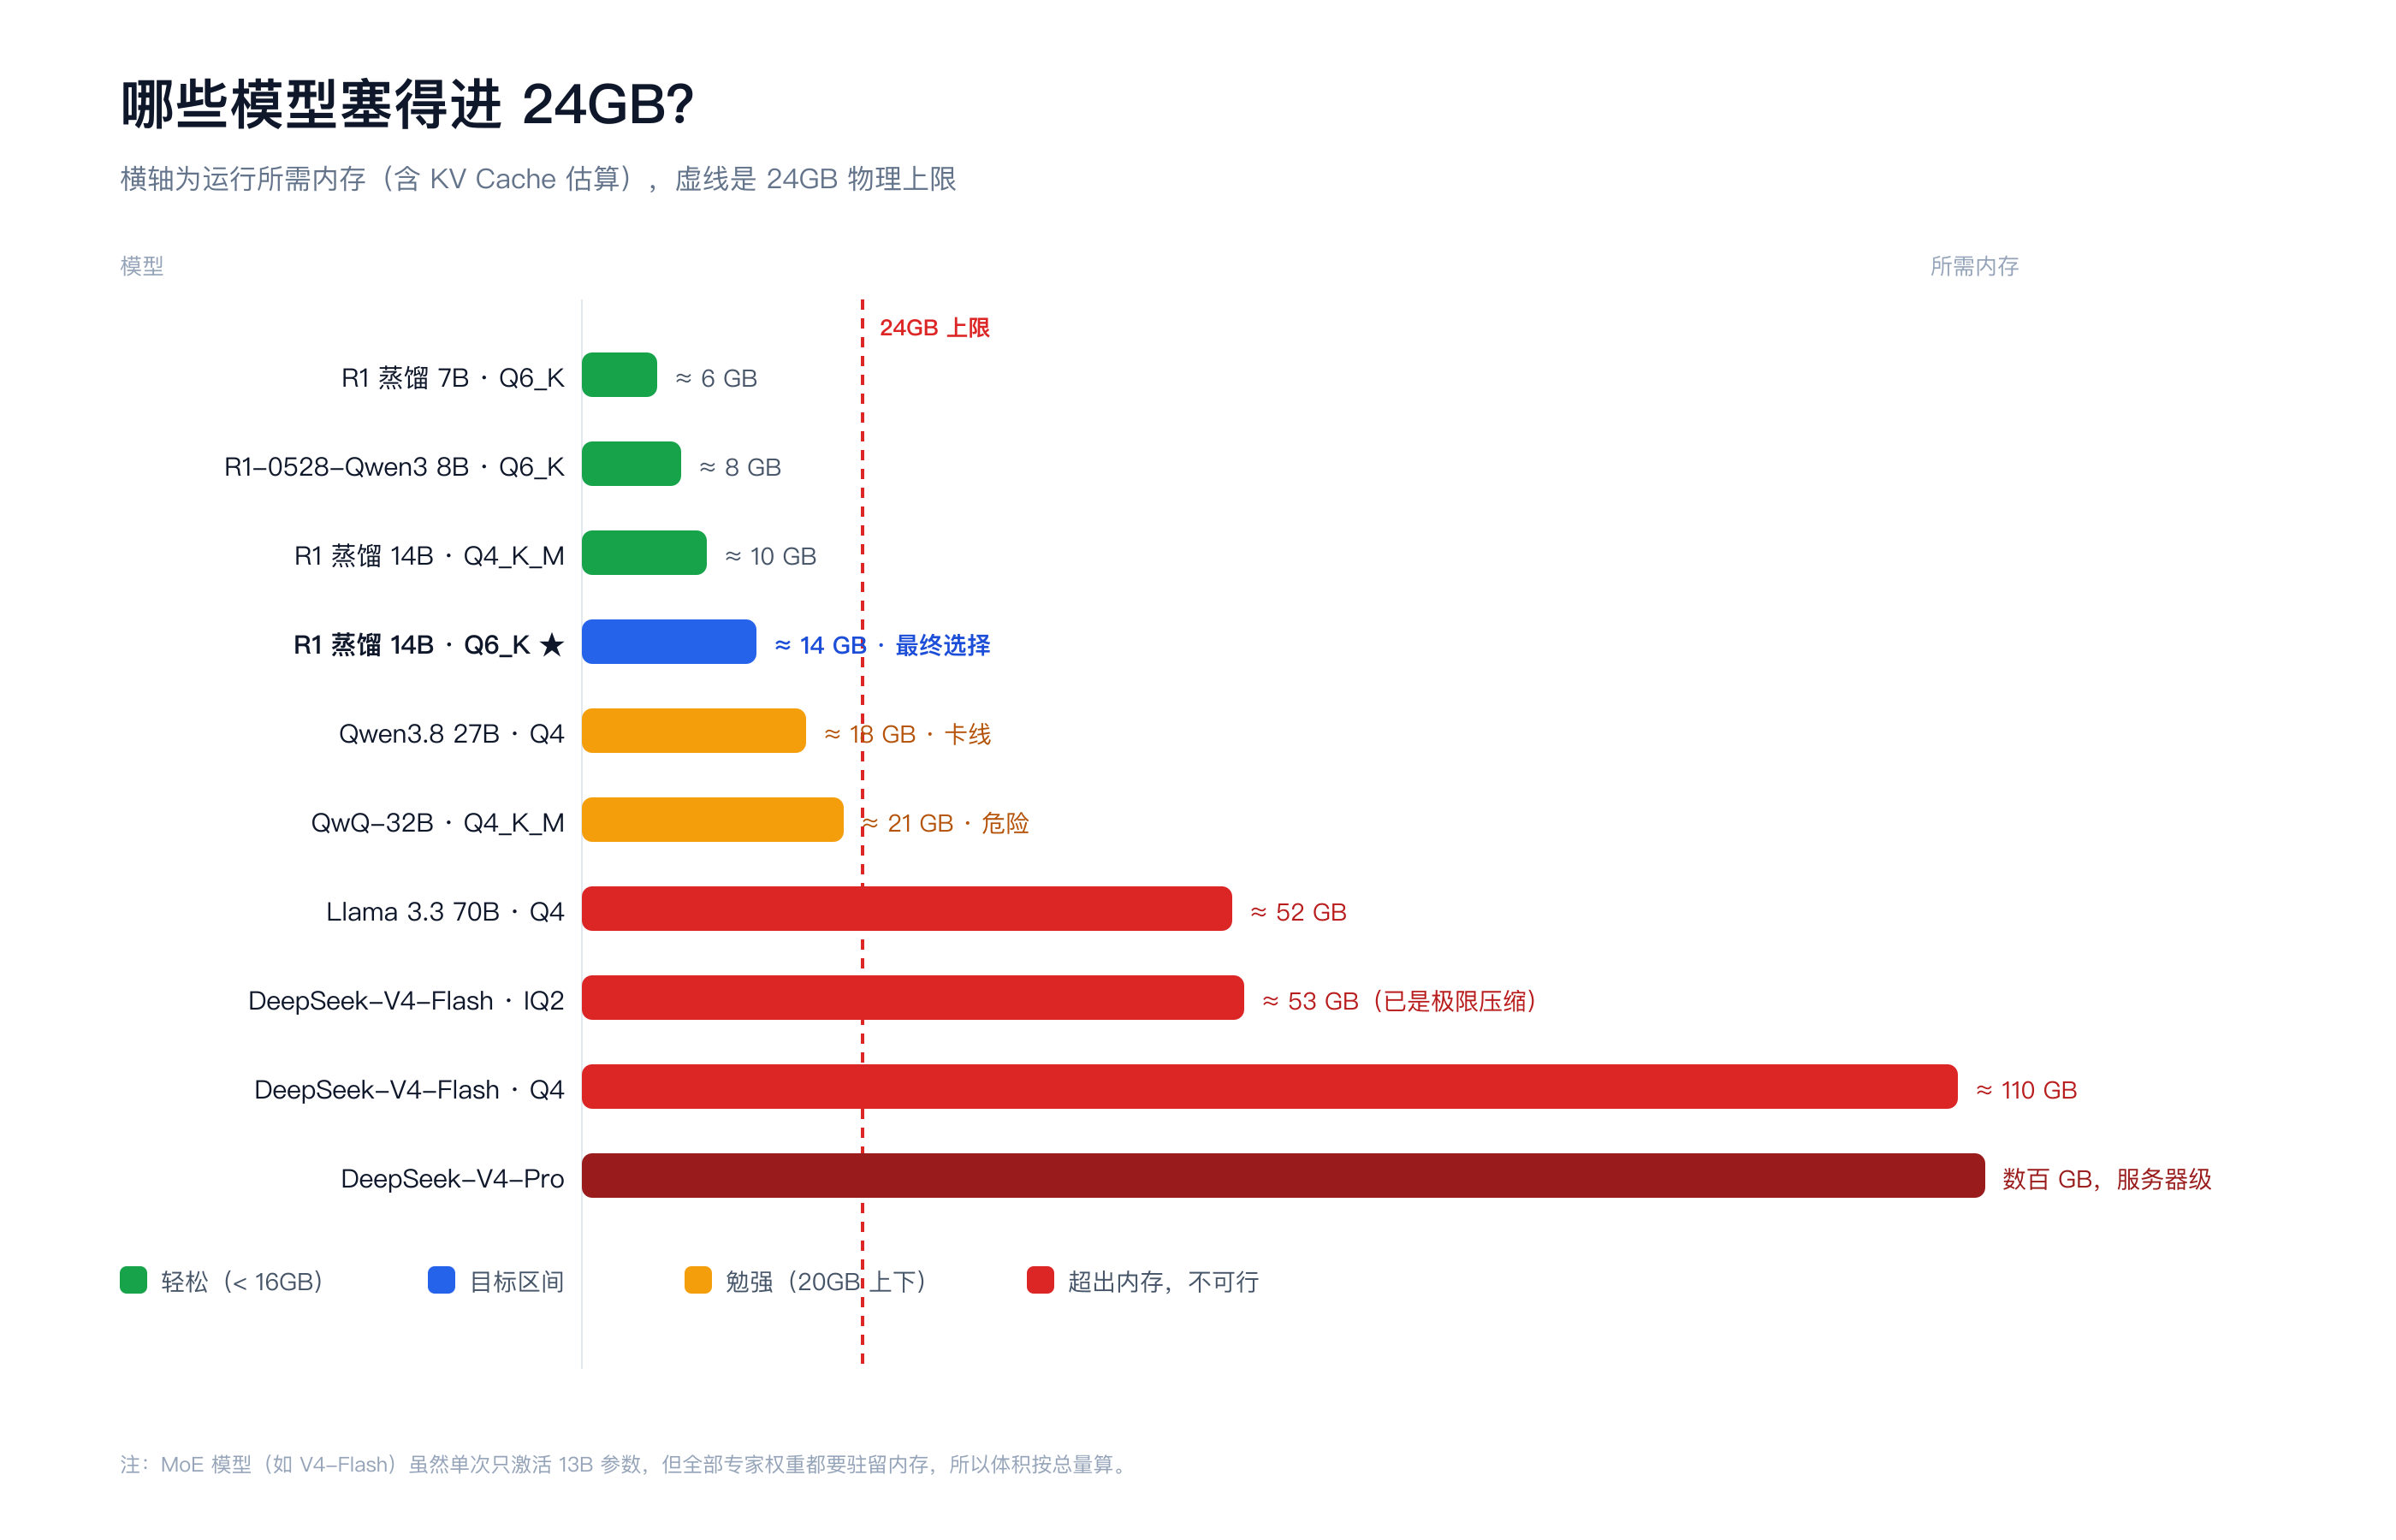
一句话结论:
- 舒服区(≤16GB):7B / 8B / 14B(Q4~Q6)
- 卡线区(18~22GB):Qwen3.8 27B Q4、QwQ-32B Q4,能跑但会碰内存压缩
- 不可能:Llama 70B、DeepSeek-V4-Flash(哪怕 IQ2 也要 53GB)、V4-Pro(数百 GB)
顺便说一个容易误解的点:MoE 模型不等于省内存。DeepSeek-V4-Flash 总参数 284B、每次只激活 13B,听起来很省,但所有专家权重都必须驻留内存,所以体积按总量算,依然是 50GB 起步。激活参数只影响算力,不影响内存占用。
选型:为什么最后是 14B + Q6_K
3.1 先认清 R1 的家族关系
DeepSeek R1 有两套 Distill 版,底座不同:
| 版本 | 底座 | 可选尺寸 | 中文 | 代码 |
|---|---|---|---|---|
| R1 Distill Qwen | 阿里 Qwen2.5 | 1.5B / 7B / 14B / 32B | 强 | 强 |
| R1 Distill Llama | Meta Llama 3.1 | 8B / 70B | 一般 | 中上 |
选 Qwen 版的理由很直接:中文理解更好,而且有 14B 这个规格。Llama 版只有 8B 和 70B,中间断层——8B 不够用,70B 装不下。
3.2 尺寸:为什么是 14B
- 7B:够快(15~20 tok/s),但代码理解深度有限,审代码容易只看表面。
- 8B:介于两者之间,速度好,深度一般。
- 14B:质量和速度的平衡点,24GB 装得下且有余量。
- 32B:Q4 就要 21GB,KV Cache 一涨就顶到天花板,速度掉到 3~4 tok/s,不适合日常挂机。
3.3 量化:为什么是 Q6_K 而不是 Q5
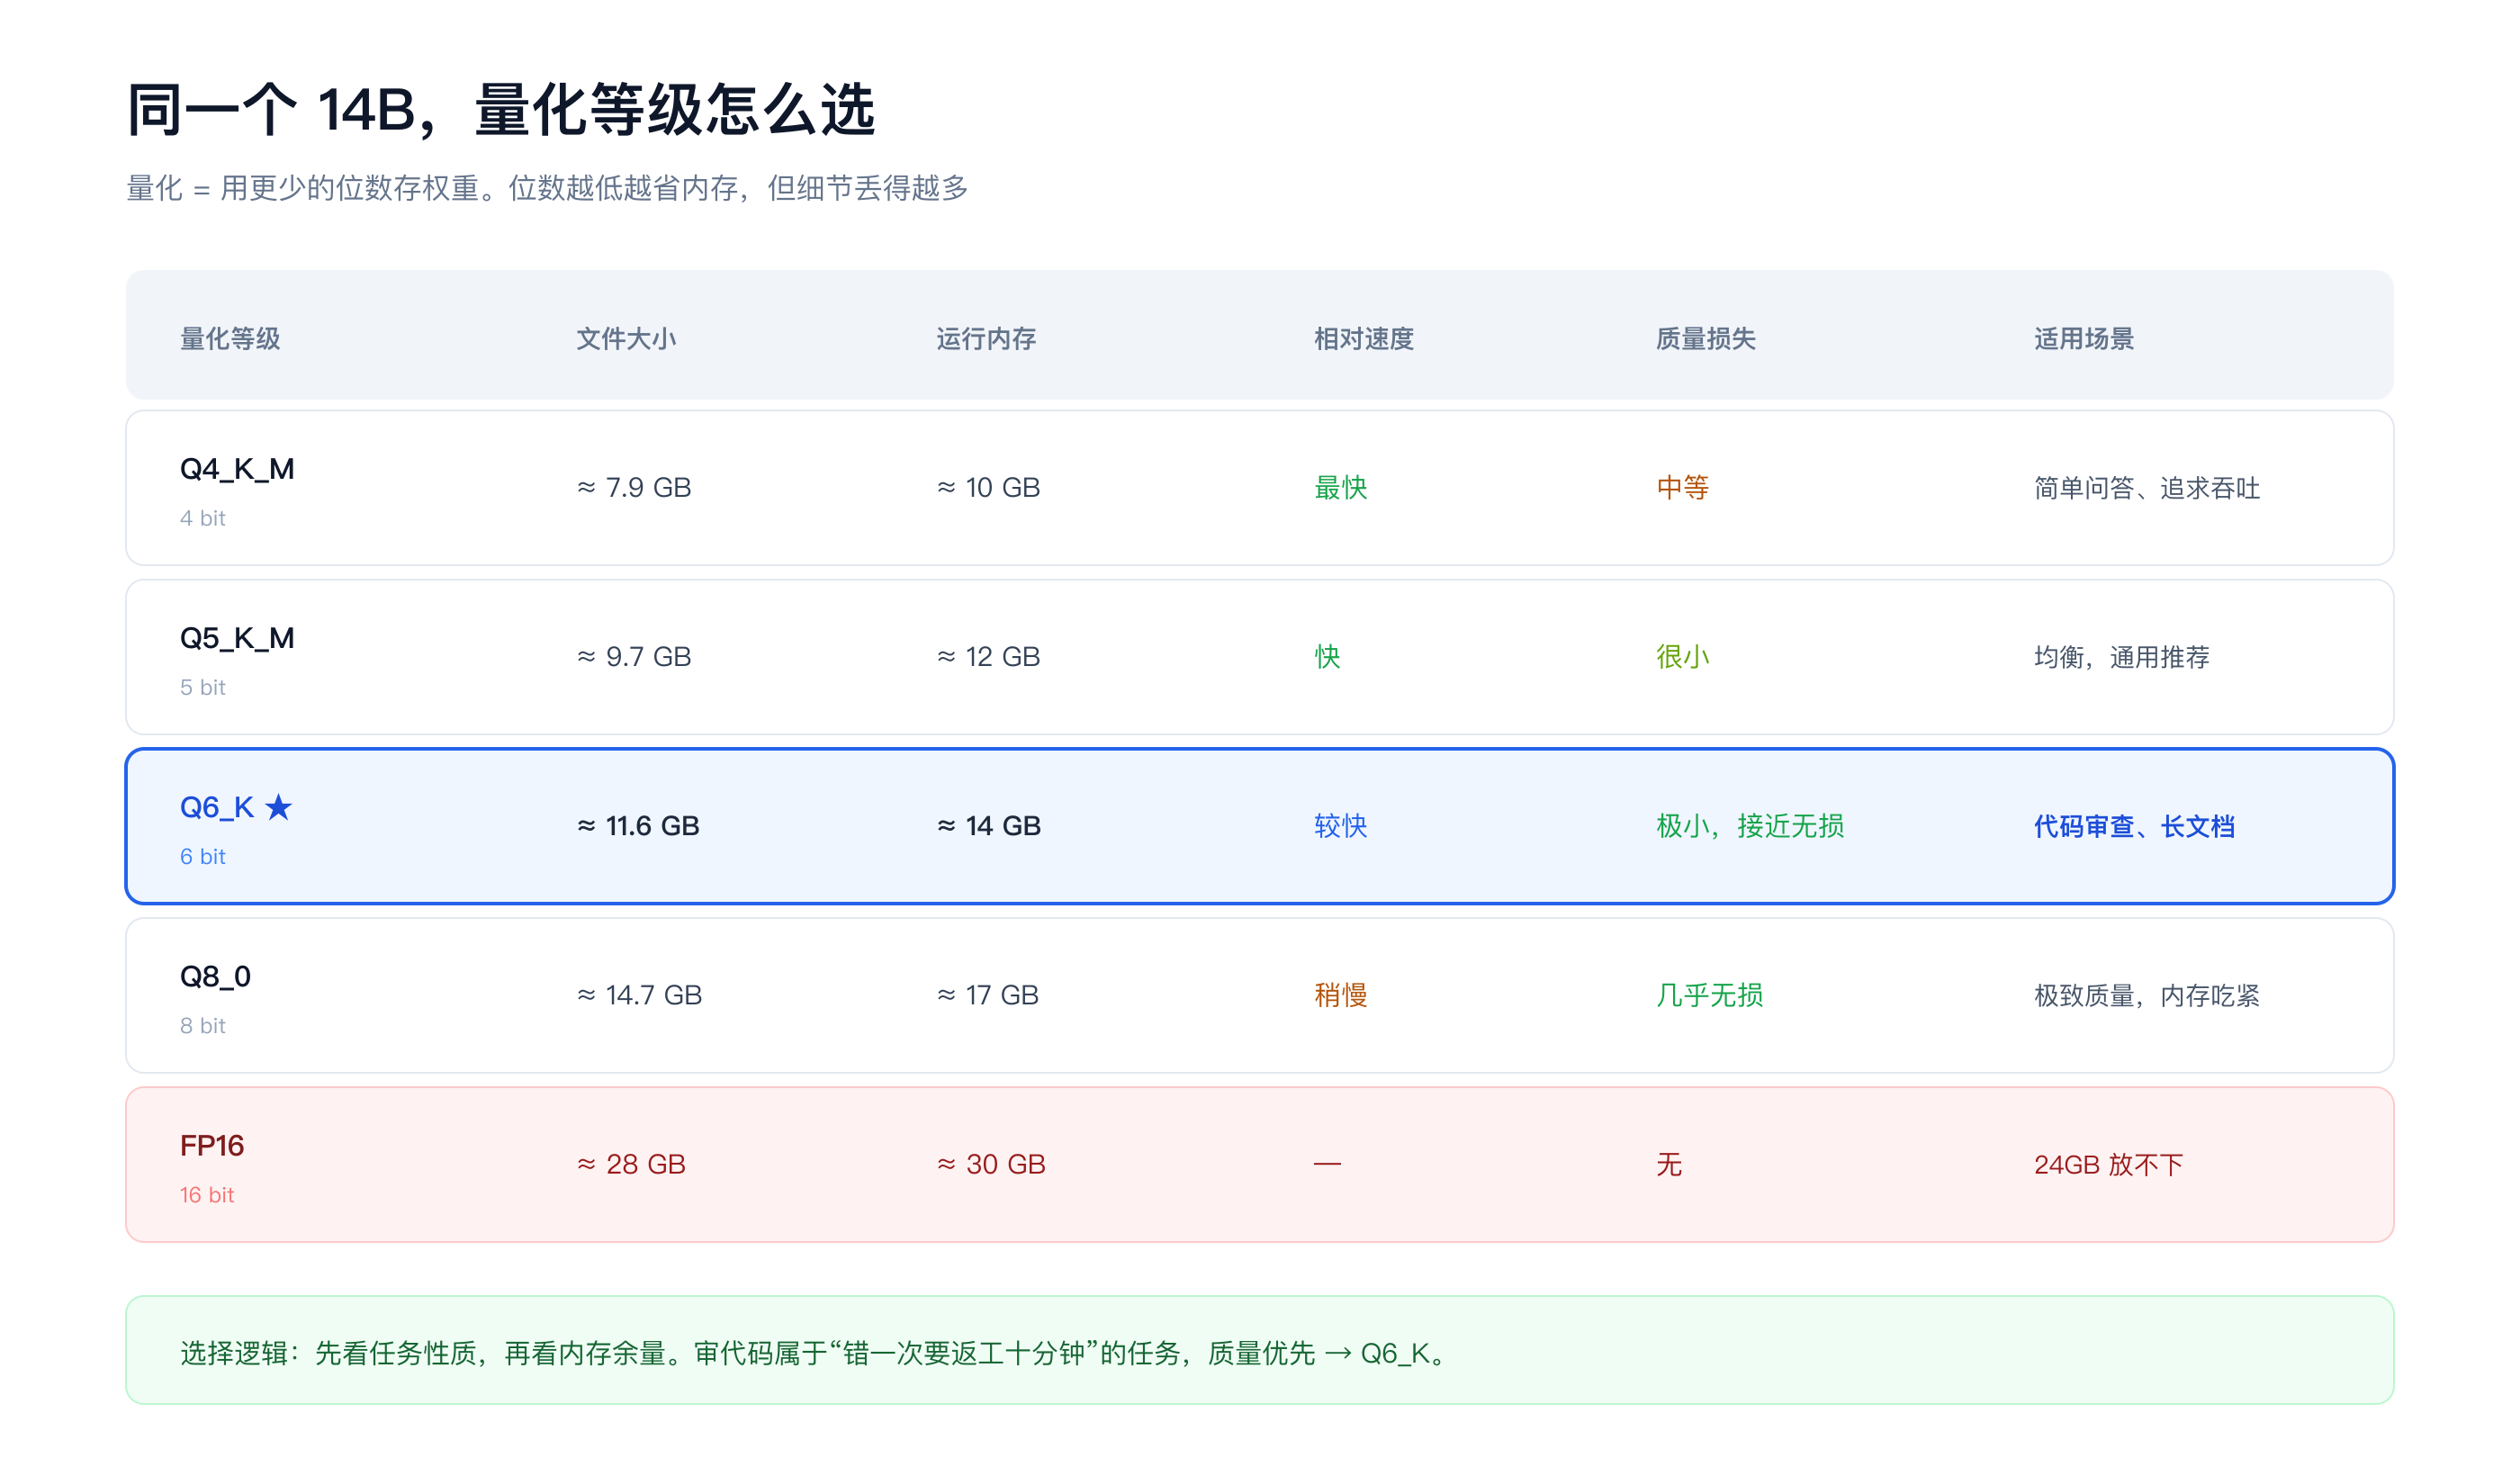
同样 14B,不同量化的差别:
| 量化 | 文件大小 | 运行内存 | 质量 | 我的判断 |
|---|---|---|---|---|
| Q4_K_M | 7.9GB | ~10GB | 中等损失 | 追求速度时用 |
| Q5_K_M | 9.7GB | ~12GB | 损失很小 | 通用均衡 |
| Q6_K | 11.6GB | ~14GB | 接近无损 | 本题答案 |
| Q8_0 | 14.7GB | ~17GB | 几乎无损 | 顶到 Metal 上限,不划算 |
选择逻辑不是"越大越好",而是"看任务性质"。审代码属于错一次要返工十分钟的任务,质量优先;而 24GB 装 Q6_K 还有 3GB 余量,所以直接上 Q6_K。
3.4 横向对比:R1 Distill vs GPT-OSS
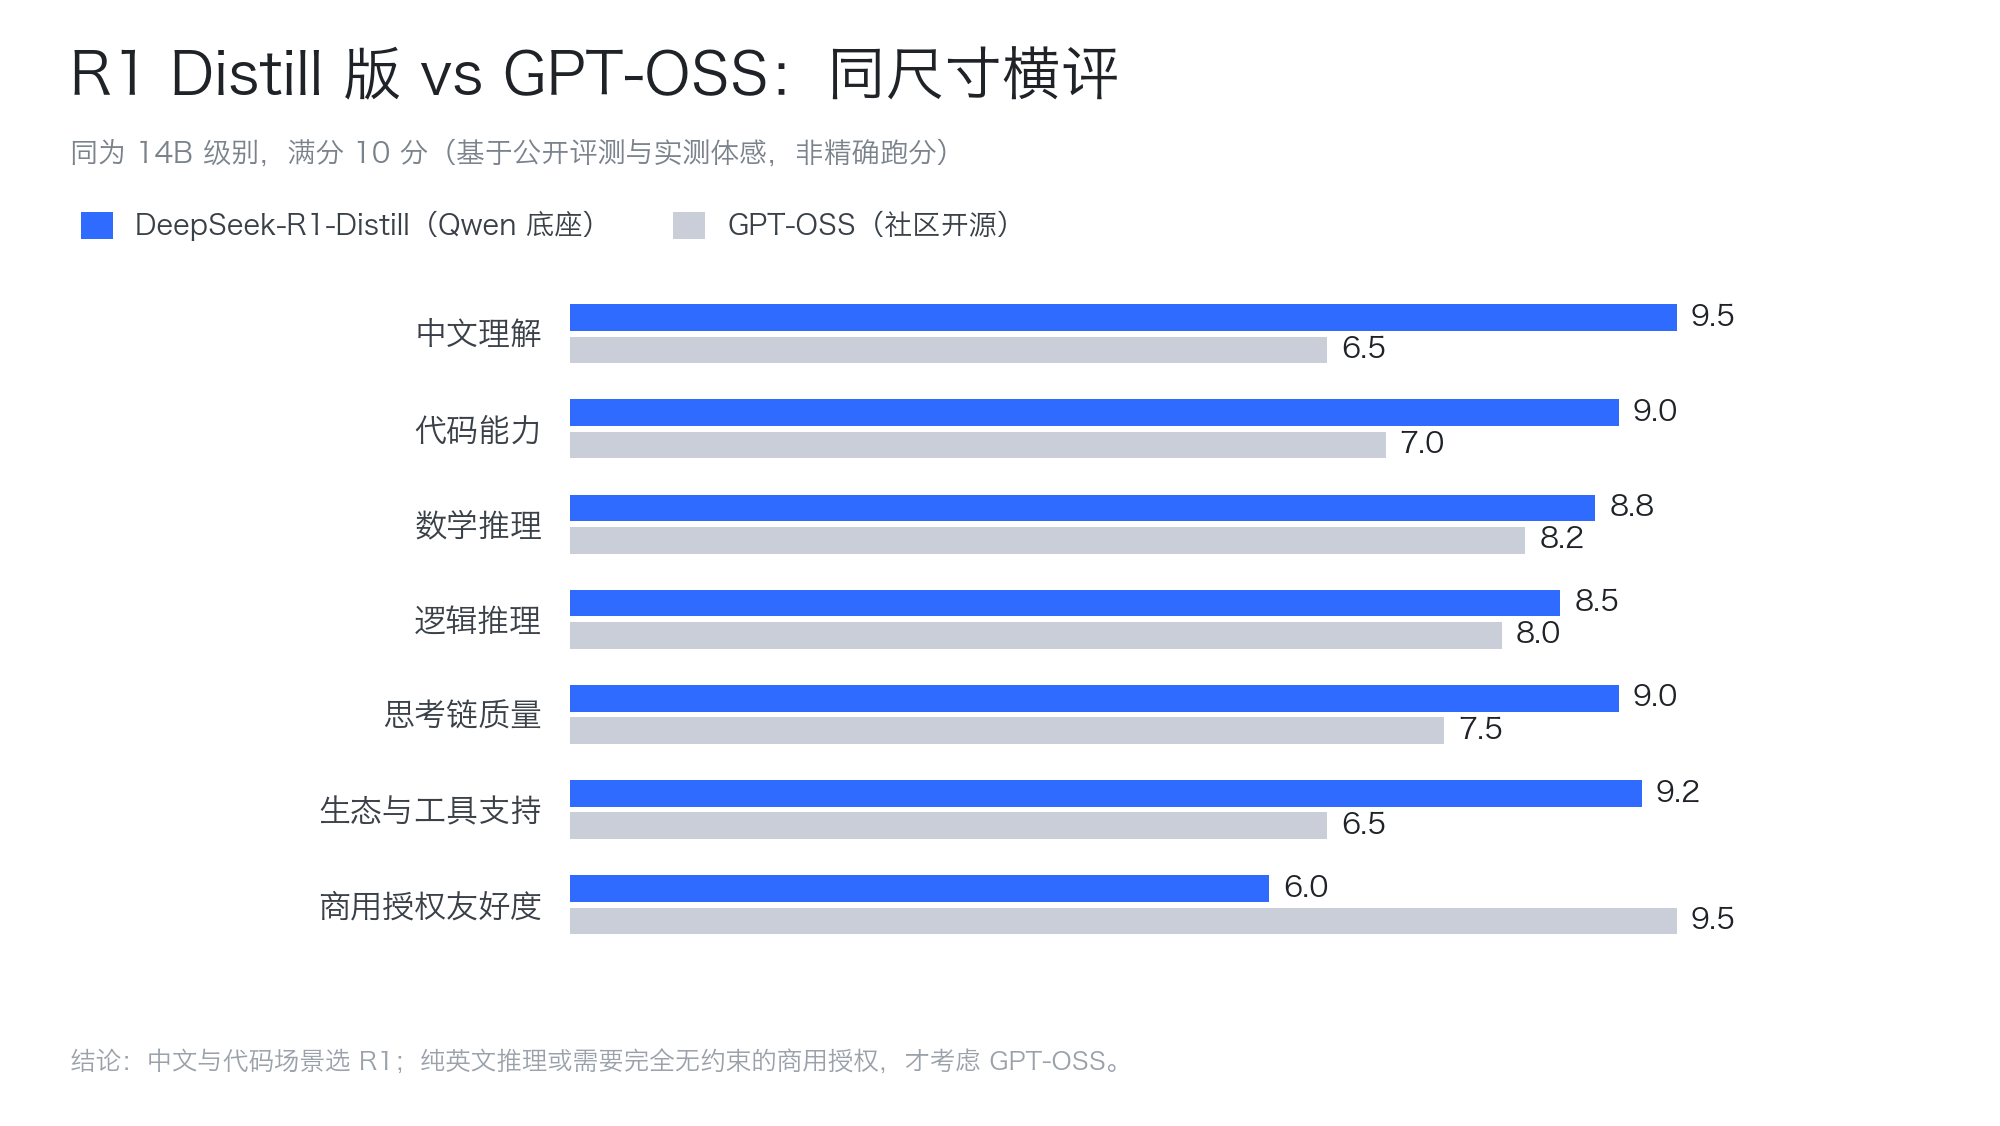
| 维度 | R1 Distill(Qwen) | GPT-OSS |
|---|---|---|
| 中文理解 | 9.5 | 6.5 |
| 代码能力 | 9.0 | 7.0 |
| 数学推理 | 8.8 | 8.2 |
| 逻辑推理 | 8.5 | 8.0 |
| 思考链质量 | 9.0 | 7.5 |
| 生态与工具支持 | 9.2 | 6.5 |
| 商用授权友好度 | 6.0 | 9.5 |
(满分 10,基于公开评测与体感,不是精确跑分。)
结论:中文 + 代码场景选 R1;纯英文推理、或需要完全无约束的商用授权,才考虑 GPT-OSS。
3.5 顺便排掉几个候选
R1-0528-Qwen3-8B(2025 年 5 月的升级 Distill 版)值得单独说:
- 它 Distill 自更强的 R1-0528,数学推理(AIME 类)明显强于旧的 14B;
- 但参数量只有 8B,代码理解深度、中文表达、综合知识都不如 14B;
- 速度快一倍(12~18 tok/s)。
如果是刷算法题,它是好选择;如果是审代码补文档,14B 仍然更合适。
DeepSeek-V4(2026 年 4 月):Pro 是 1.6T 总参 / 49B 激活,Flash 是 284B / 13B 激活,最小量化也要 46GB 起,本地 24GB 完全没戏,而且 V4 没有 Distill 小模型。所以"等 V4 出小版本"这件事,短期内等不到。
Qwen3.8 27B(2026 年 8 月,知识截止 2026-02):是目前能塞进 24GB 的最新模型,带思考模式,但 Q4 约 18GB,速度 3~5 tok/s,属于"能跑但不好受"。
3.6 最终决策
| 项目 | 选择 | 理由 |
|---|---|---|
| 模型 | DeepSeek-R1-Distill-Qwen-14B | 中文 + 代码双优,有 14B 规格 |
| 量化 | Q6_K | 接近无损,内存仍有余量 |
| 运行时 | llamafile(单文件) | 不用编译,自带 Metal 加速 |
| 上下文 | 8192 | 够审单文件,KV 只占 1.5GB |
动手:下载与启动
4.1 用国内镜像下载
HuggingFace 直连不稳,用 ModelScope(魔搭):
pip install modelscope

mkdir -p ~/llm-models/models

modelscope download \
  --model Mozilla/DeepSeek-R1-Distill-Qwen-14B-llamafile \
  --local_dir ~/llm-models/models
仓库名以 ModelScope 页面上的实际名称为准。下载完成后目录结构是
models/Mozilla--DeepSeek-R1-Distill-Qwen-14B-llamafile/snapshots/master/。
如果习惯 HuggingFace CLI,也可以用国内镜像站:
pip install -U "huggingface_hub[cli]"
export HF_ENDPOINT=https://hf-mirror.com

hf download Mozilla/DeepSeek-R1-Distill-Qwen-14B-llamafile \
  --include "*Q6_K.llamafile" \
  --local-dir ~/llm-models/models
下载完检查一下:
ls -lh ~/llm-models/models/Mozilla--DeepSeek-R1-Distill-Qwen-14B-llamafile/snapshots/master/
# 期望看到 DeepSeek-R1-Distill-Qwen-14B-Q6_K.llamafile,约 12G
给个短名字,后面命令好写:
cd ~/llm-models
ln -sf models/Mozilla--DeepSeek-R1-Distill-Qwen-14B-llamafile/snapshots/master/DeepSeek-R1-Distill-Qwen-14B-Q6_K.llamafile \
       DeepSeek-R1-14B-Q6_K.llamafile
chmod +x DeepSeek-R1-14B-Q6_K.llamafile
4.2 启动命令
cd ~/llm-models
./DeepSeek-R1-14B-Q6_K.llamafile \
  --server \
  --nobrowser \
  --host 0.0.0.0 \
  --port 8080 \
  -ngl 999 \
  --ctx-size 8192
参数逐个解释:
| 参数 | 作用 | 为什么这么设 |
|---|---|---|
--server |
只跑 HTTP 服务,不进入聊天 CLI | 必须加,见下面的坑 |
--nobrowser |
不自动打开浏览器 | 无人值守/远程时避免多余动作 |
--host 0.0.0.0 |
监听所有网卡 | 让局域网其他机器能访问 |
--port 8080 |
服务端口 | 与后面代理的 8081 区分 |
-ngl 999 |
尽可能多卸载到 GPU | Metal 加速,不然纯 CPU 会很慢 |
--ctx-size 8192 |
上下文长度 | 8K 够用,再大 KV Cache 线性增长 |
4.3 坑一:进程启动后立刻退出
第一次按"直觉"启动,进程打印完 banner 就退了,端口一直不通:
software: llamafile 0.9.2
model:    DeepSeek-R1-Distill-Qwen-14B-Q6_K.gguf
compute:  Apple Metal GPU
server:   http://127.0.0.1:8080/
原因:llamafile 默认是 --chat 模式——前台跑一个聊天 CLI,同时在后台起 server。CLI 的 stdin 一关(比如 nohup、管道、后台任务),CLI 收到 EOF 退出,后台 server 跟着一起死。
从日志里能看到那个 ^D(EOF)就是证据。修复办法就是显式加 --server,只跑服务,不要前台 CLI。
4.4 坑二:沙箱初始化失败
加了 --server 之后,日志继续往前走了,模型也加载了:
ggml_metal_init: recommendedMaxWorkingSetSize = 17179.89 MB
llama_kv_cache_init: Metal KV buffer size = 1536.00 MiB
llama_new_context_with_model: Metal compute buffer size = 696.00 MiB
llama server listening at http://127.0.0.1:8080
opening browser tab... (pass --nobrowser to disable)
sandbox initialization failed: Operation not permitted
它在尝试打开浏览器时做了一次沙箱初始化,被环境拦住了,于是整个进程退出。两个处理方式:
- 加
--nobrowser(推荐,本来也不需要它自己开浏览器); - 如果环境本身限制了沙箱创建(比如在受限 shell / 嵌套沙箱里跑),再加
--unsecure关掉 llamafile 自己的沙盒:
./DeepSeek-R1-14B-Q6_K.llamafile --server --nobrowser --unsecure \
  --host 0.0.0.0 --port 8080 -ngl 999 --ctx-size 8192
正常桌面终端里通常不需要 --unsecure,这只是受限环境下的兜底。
4.5 验证服务
curl -s http://127.0.0.1:8080/v1/models | head -c 300

curl -s http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "DeepSeek-R1-Distill-Qwen-14B-Q6_K",
    "messages": [{"role": "user", "content": "用一句话解释什么是依赖注入"}],
    "max_tokens": 200
  }'
看到正常 JSON 回复,说明服务可用。
4.6 开机自启(可选)
用 launchd 托管,比自己写 nohup 稳:
<!-- ~/Library/LaunchAgents/com.zhoubo.llamafile.plist -->
<?xml version="1.0" encoding="UTF-8"?>
<!DOCTYPE plist PUBLIC "-//Apple//DTD PLIST 1.0//EN" "http://www.apple.com/DTDs/PropertyList-1.0.dtd">
<plist version="1.0">
<dict>
  <key>Label</key><string>com.zhoubo.llamafile</string>
  <key>ProgramArguments</key>
  <array>
    <string>/Users/zhoubo/llm-models/DeepSeek-R1-14B-Q6_K.llamafile</string>
    <string>--server</string>
    <string>--nobrowser</string>
    <string>--host</string><string>0.0.0.0</string>
    <string>--port</string><string>8080</string>
    <string>-ngl</string><string>999</string>
    <string>--ctx-size</string><string>8192</string>
  </array>
  <key>WorkingDirectory</key><string>/Users/zhoubo/llm-models</string>
  <key>RunAtLoad</key><true/>
  <key>KeepAlive</key><true/>
  <key>StandardOutPath</key><string>/Users/zhoubo/llm-models/llama.log</string>
  <key>StandardErrorPath</key><string>/Users/zhoubo/llm-models/llama.err.log</string>
</dict>
</plist>
launchctl load -w ~/Library/LaunchAgents/com.zhoubo.llamafile.plist
launchctl list | grep llamafile
局域网接入 workbuddy
5.1 先拿到局域网地址
ipconfig getifaddr en0 # 例如 192.168.1.138
模型服务已经用 --host 0.0.0.0 启动,所以这个地址直接可达:
curl -s -o /dev/null -w "%{http_code}\n" http://192.168.1.138:8080/
5.2 workbuddy 里的三个字段
| 配置项 | 填写 | 说明 |
|---|---|---|
| Base URL / API 地址 | http://192.168.1.138:8081/v1 |
走代理,不要直连 8080 |
| API Key | 随便填(如 sk-local) |
本地服务不校验 |
| 模型名称 | DeepSeek-R1-Distill-Qwen-14B-Q6_K |
必须和 /v1/models 返回的一致 |
5.3 高级选项逐个说明
这些开关决定了 workbuddy 往请求里塞什么内容,填错会直接导致 500。
| 选项 | 含义 | 本地 R1 该怎么设 |
|---|---|---|
| 工具调用(Function Calling) | 允许模型调用外部工具/函数,请求里会带 tools 字段 |
关。llama.cpp 对 tools 支持有限,开了容易报错 |
| 图片输入(多模态) | 允许上传图片,content 会变成数组 | 关。这是纯文本模型 |
| 思考模式 | 展示 <think> 推理链 |
开。审代码时能看到它的判断依据 |
| 仅思考模式 | 只输出思考过程,不输出答案 | 关。除非你在做推理研究 |
| 允许关闭思考 | 允许临时关掉思考链 | 开。简单问题不想等它想太久 |
| 自定义协议 | 用非 OpenAI 协议对接 | 关。llamafile 走标准 OpenAI 兼容格式 |
推荐组合:
✅ 思考模式
✅ 允许关闭思考
⬜ 工具调用
⬜ 图片输入
⬜ 仅思考模式
⬜ 自定义协议
5.4 "标准 OpenAI 格式"到底指什么
就是一套大家约定俗成的接口形状:
- 路径:
/v1/chat/completions - 请求体:
{"model": ..., "messages": [...], "stream": true} - 回复:
choices[0].message.content,流式则是一串data: {...}
OpenAI 最早定义了这套规则,后来 DeepSeek、通义、智谱、本地 llama.cpp 全都照着做。好处是换模型只改地址和模型名,工具不用改代码。
踩坑:一个 500 错误
6.1 现象
workbuddy 里"配置测试"是通过的,但一发真实消息就报错:
Message: 自定义模型 custom-local:DeepSeek-R1-Distill-Qwen-14B-Q6_K 错误,请切换模型或重试。
Error Code: 10000
Server Detail: {"code":-32603,"message":"Internal error","data":{"statusCode":500,
"details":"500 500 Internal Server Error
[json.exception.type_error.302] type must be string, but is array"}}
6.2 先做两个判断
- 配置测试通过 → 网络、地址、模型名都没问题,问题在请求内容。
type must be string, but is array→ 有个字段本该是字符串,实际传了数组。
6.3 根因
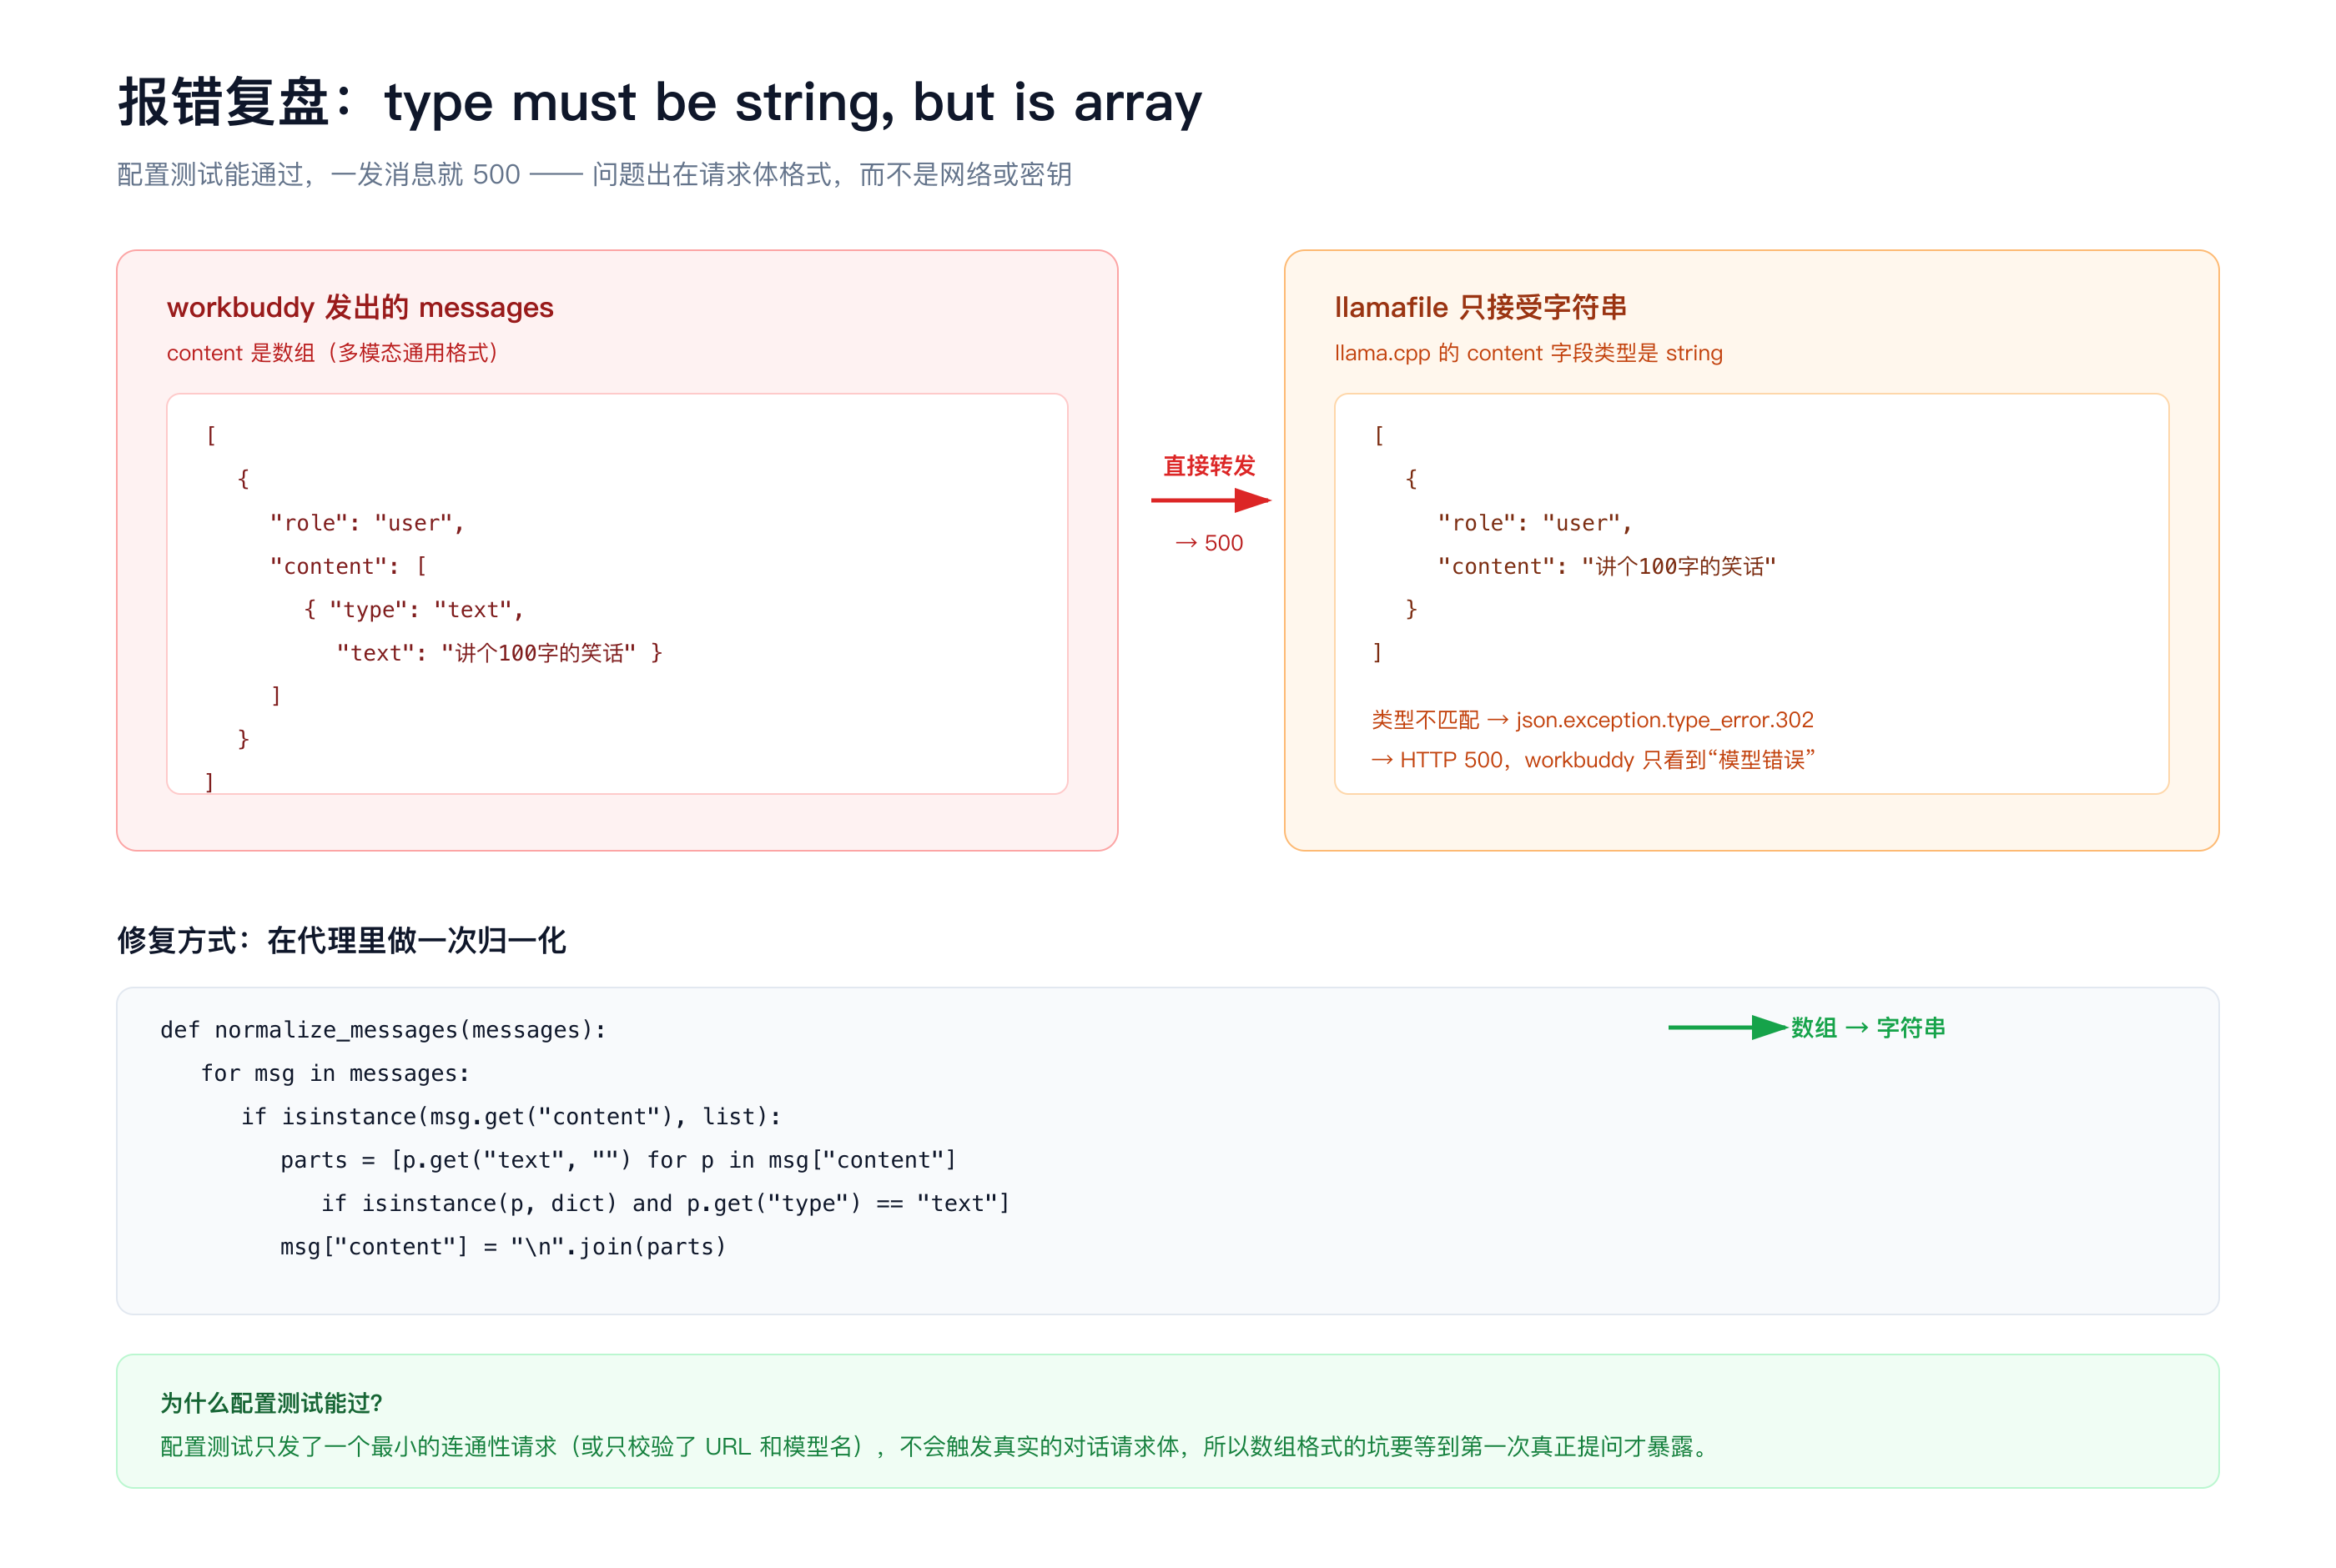
workbuddy 用的是多模态通用格式,content 是数组:
{
  "role": "user",
  "content": [
    { "type": "text", "text": "讲个100字的笑话" }
  ]
}
而 llama.cpp 的 content 字段类型是 string:
{
  "role": "user",
  "content": "讲个100字的笑话"
}
类型不匹配 → json.exception.type_error.302 → 500。workbuddy 只看到"模型错误",因为 500 被它统一包装了。
为什么配置测试能过? 因为配置测试通常只发一个最小连通性请求,或者只校验 URL 和模型名,不会带真实对话的 content 数组。所以这个坑要等到第一次真正提问才暴露。
6.4 修复:写一层代理做归一化
最直接的办法是在中间加一层代理,把数组拍平成字符串:
def normalize_messages(messages):
    for msg in messages:
        content = msg.get("content")
        if isinstance(content, list):
            parts = [p.get("text", "") for p in content
                     if isinstance(p, dict) and p.get("type") == "text"]
            msg["content"] = "\n".join(parts)
    return messages
代理同时做三件事:改格式、转发请求、记指标。
def _proxy(self):
    body = self.rfile.read(int(self.headers.get('Content-Length', 0)))
    start = time.time()

    # 1) 归一化请求体
    if body and '/chat/completions' in self.path:
        data = json.loads(body)
        if 'messages' in data:
            data['messages'] = normalize_messages(data['messages'])
        body = json.dumps(data, ensure_ascii=False).encode()

    # 2) 转发到上游
    req = urllib.request.Request(UPSTREAM + self.path, data=body, method=self.command)
    for k, v in self.headers.items():
        if k.lower() not in ('host', 'content-length'):
            req.add_header(k, v)
    with urllib.request.urlopen(req) as resp:
        resp_body = resp.read()
        self.send_response(resp.status)
        for k, v in resp.getheaders():
            if k.lower() != 'transfer-encoding':
                self.send_header(k, v)
        self.end_headers()
        self.wfile.write(resp_body)

    # 3) 记指标
    latency_ms = (time.time() - start) * 1000
    usage = json.loads(resp_body).get('usage', {})
    record(usage, latency_ms)
改完之后 workbuddy 里只改一个地方:Base URL 从 8080 换成 8081,其他不变。
为什么还要加一个监控程序
7.1 本地模型是个黑盒
服务跑起来之后,你只能看到"出了字"或"没出字"。中间发生了什么,完全不知道:
- 它是在算,还是卡死了?
- 速度掉到 3 tok/s 是因为上下文太长,还是内存不够在换页?
- 昨晚那批代码审查任务,到底跑完了几条,失败了几条?
- 换个量化档位,速度到底差多少?
这些问题的答案,不装监控就只能靠猜。
7.2 代理天然就是观测点
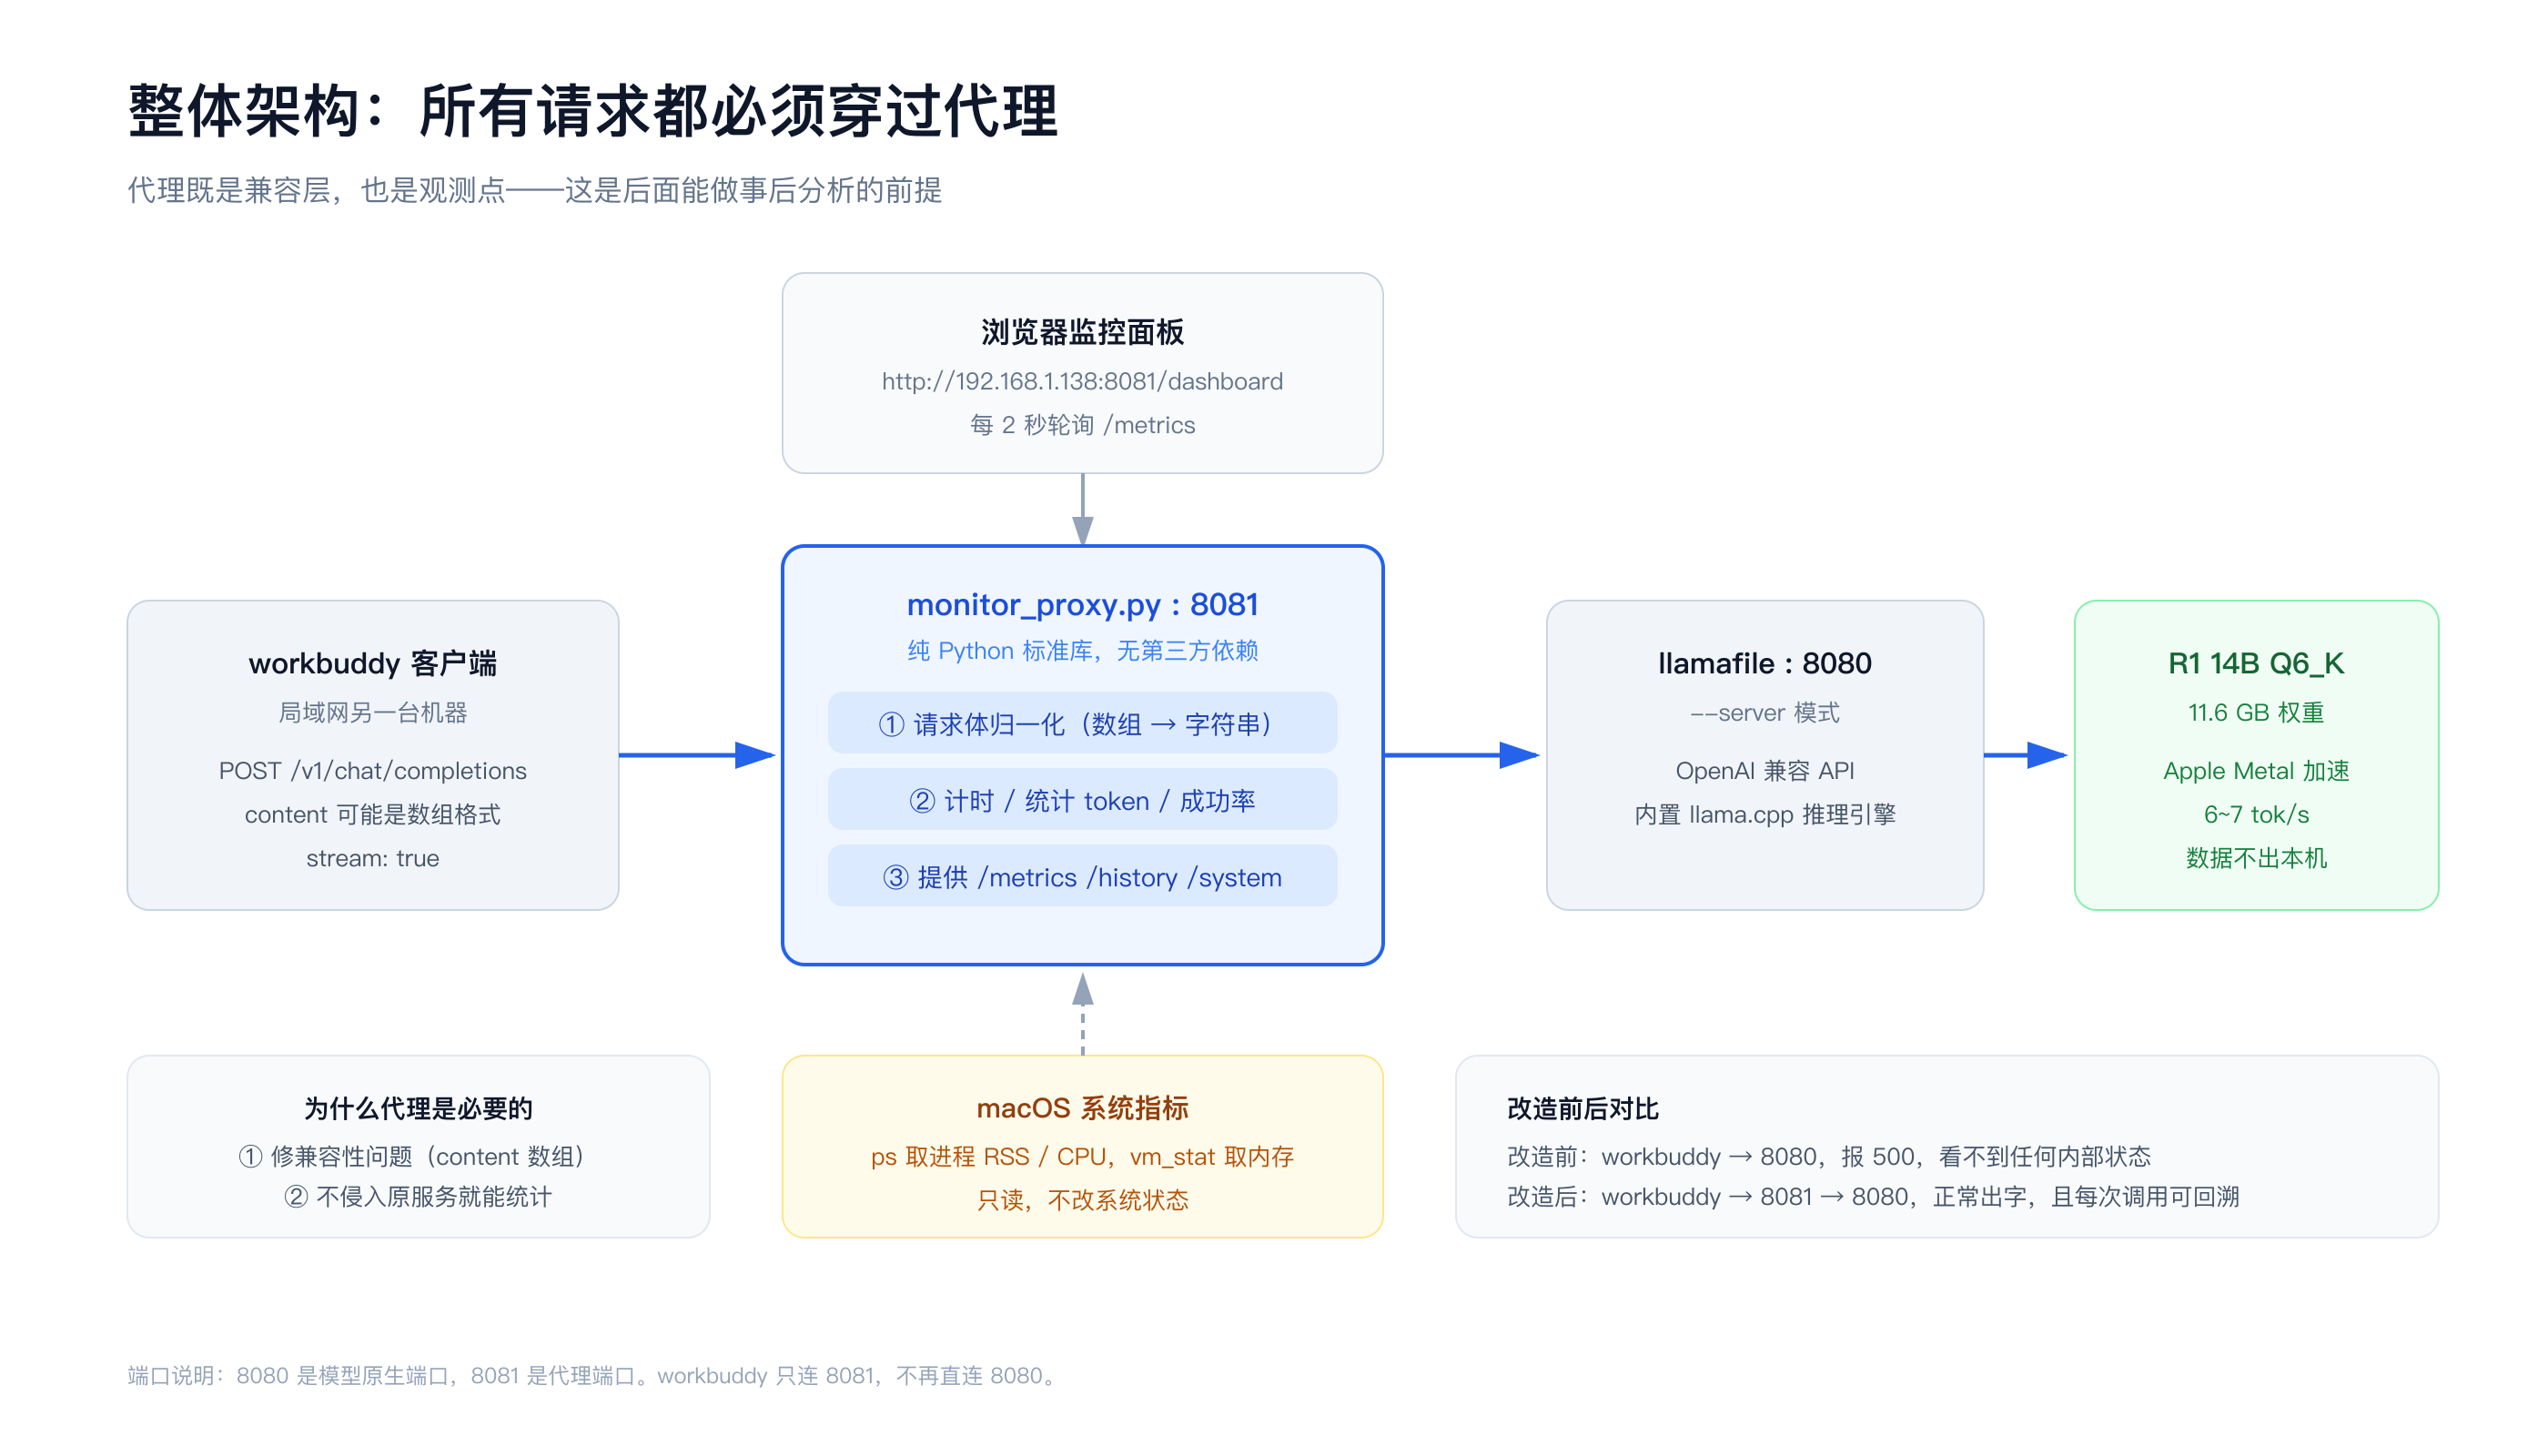
既然为了解决 500 错误已经加了代理,那所有请求必然经过它。这就是最好的埋点位置:不用改模型、不用改客户端,直接在转发路径上计时和统计。
代理对外提供四个接口:
| 路径 | 用途 |
|---|---|
/dashboard |
可视化面板(HTML) |
/metrics |
汇总指标(JSON) |
/metrics/history |
最近请求明细(JSON) |
/system |
系统资源(JSON,只读命令) |
7.3 四个必须盯住的指标
| 指标 | 怎么看 | 异常信号 |
|---|---|---|
| 生成速度 tok/s | 单次 completion_tokens / 耗时 | 从 6.5 掉到 3 以下 → 上下文过长或内存吃紧 |
| 端到端耗时 | 请求进入到返回 | 突然翻倍 → 队列堆积或 swap |
| 成功率 | 2xx / 总数 | 出现 5xx → 格式不兼容、上下文超限 |
| 系统内存 / swap | vm_stat + sysctl vm.swapusage |
内存接近 90%、swap 持续上涨 → 该换小模型了 |
7.4 面板长什么样
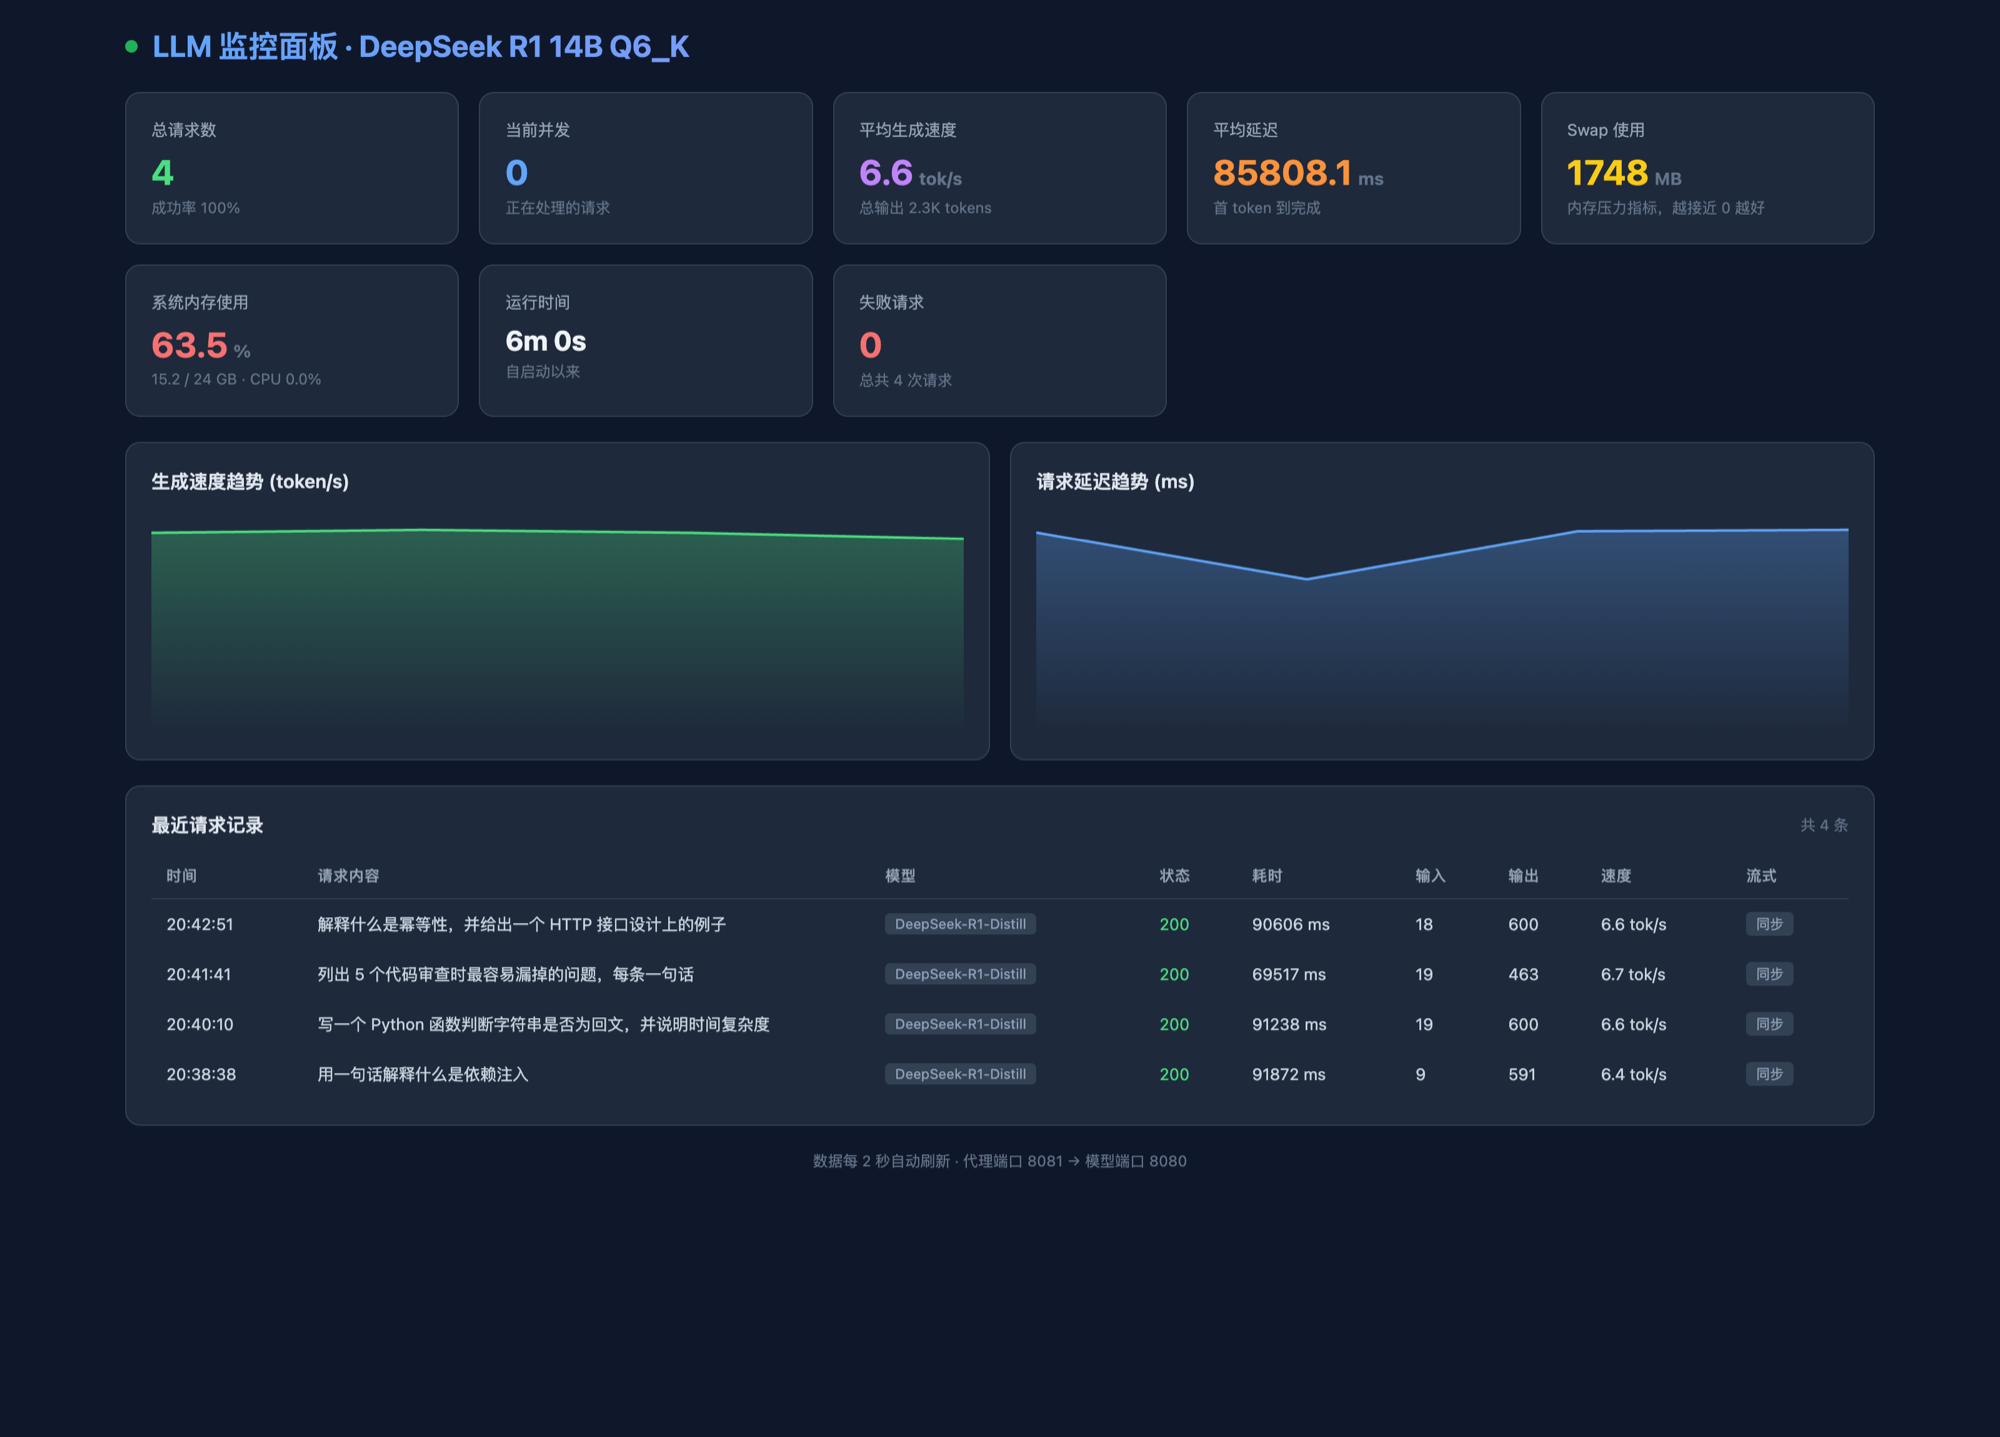
这张是真实运行时的截图(发了 4 次真实请求):
- 总请求 4,成功率 100%
- 平均速度 6.6 tok/s,总输出 2.3K tokens
- 平均端到端 85.8 秒(包含完整生成时间)
- 系统内存 63.5%(15.2 / 24 GB)
- Swap 1748 MB
7.5 两个实现坑(都踩了)
坑一:杂请求污染统计。 浏览器会请求 /favicon.ico,代理把它也当成一次请求记下来,结果面板上出现 404、成功率掉到 66.7%。修复:只统计 /v1 开头的路径。
is_api = self.path.startswith('/v1')
if not is_api:
    return   # 只转发,不计入指标
坑二:模型内存读成 0。 一开始用 ps -C 按进程名匹配,匹配不到(进程实际叫 .ape-1.10);换成按命令行匹配后,RSS 只有 700MB——因为 GGUF 权重是 mmap 的,Metal 缓冲也不计入进程 RSS。footprint -p 也只报 1.6GB。
所以"模型内存"这个指标不能看进程,要看系统口径:vm_stat 的 active + wired + compressed。最后面板改成展示"系统内存使用率 + Swap",这才是可信的。
vm_stat | head -8
sysctl -n vm.swapusage
memory_pressure | tail -1
补一句:截图上 swap 显示 1.7GB,但 memory_pressure 显示可用内存 74%,说明这 1.7GB 是系统历史上的写入量,当前并没有频繁换出。只看 swap 数字容易被吓到,要配合内存压力一起看。
让它安静地跑一整晚
8.1 禁止睡眠
sudo pmset -a sleep 0        # 永不休眠
pmset -g | grep -E "sleep|disksleep"
显示器可以照常睡眠,不影响推理。也可以临时用 caffeinate -s 包一层。
8.2 资源预期
| 项目 | 预期 |
|---|---|
| CPU | 生成时 4 个性能核接近满载 |
| 内存 | 稳定 14~15GB,不会持续上涨(每轮请求结束 KV 会清) |
| 温度 | 会热,但 Mac mini 散热够用,风扇声可闻 |
| 速度衰减 | 上下文越长越慢,8K 上下文下 6~7 tok/s 是常态 |
8.3 重启之后怎么恢复
按顺序检查三件事:
lsof -nP -iTCP -sTCP:LISTEN | grep -E "8080|8081"   # 两个端口是否在
curl -s -o /dev/null -w "%{http_code}\n" http://127.0.0.1:8080/  # 模型
curl -s -o /dev/null -w "%{http_code}\n" http://127.0.0.1:8081/dashboard  # 代理
ipconfig getifaddr en0                              # IP 有没有变
IP 变了的话,workbuddy 里的地址要跟着改。想彻底省事,在路由器里给这台机器绑定固定 IP。
复盘:这次踩到的坑和结论
9.1 问题清单
| # | 问题 | 根因 | 解决 |
|---|---|---|---|
| 1 | 进程启动后立刻退出 | llamafile 默认 --chat,stdin EOF 连带 server 退出 |
加 --server |
| 2 | 沙箱初始化失败 | 打开浏览器触发 sandbox_init 被拒 | --nobrowser,必要时 --unsecure |
| 3 | workbuddy 发消息 500 | content 是数组,llama.cpp 要字符串 | 代理做归一化 |
| 4 | 面板成功率不是 100% | favicon 等杂请求被计入 | 只统计 /v1 |
| 5 | 模型内存显示 0 | mmap 权重不进 RSS,ps -C 也匹配不到 |
改用系统口径 + swap |
| 6 | 机器夜里休眠导致服务断 | 默认节能策略 | pmset -a sleep 0 |
9.2 结论
- 24GB 跑 14B 是舒服的,不是"勉强"。真正的瓶颈是 Metal 的 17.2GB 工作集上限,而不是 24GB 总量。
- 量化选 Q6_K 是对的:多花 2GB 换接近无损的质量,对代码任务很值。
- llamafile 单文件方案适合快速验证,缺点是参数行为不够直观(
--chat默认、自动开浏览器),踩过就懂了。 - 兼容性问题几乎都出在"请求格式"上,不在网络和密钥上。遇到 500 先看请求体。
- 监控不是锦上添花:挂机场景下,没有指标你就无法判断它是在干活还是在硬撑。
9.3 如果再来一次
- 先确认
--server再谈别的,能省半小时。 - 代理从第一天就上,格式兼容和监控一起解决。
- 面板指标只信"系统口径",进程口径对 mmap 模型不可靠。
- 把 IP 固定下来,别每次重启都改客户端。
附录 A:完整命令清单
# 1. 下载模型(国内镜像)
pip install modelscope
mkdir -p ~/llm-models/models
modelscope download --model Mozilla/DeepSeek-R1-Distill-Qwen-14B-llamafile \
  --local_dir ~/llm-models/models

# 2. 建软链接
cd ~/llm-models
ln -sf models/Mozilla--DeepSeek-R1-Distill-Qwen-14B-llamafile/snapshots/master/DeepSeek-R1-Distill-Qwen-14B-Q6_K.llamafile \
       DeepSeek-R1-14B-Q6_K.llamafile

# 3. 启动模型服务
./DeepSeek-R1-14B-Q6_K.llamafile --server --nobrowser \
  --host 0.0.0.0 --port 8080 -ngl 999 --ctx-size 8192

# 4. 启动监控代理
python3 ~/llm-models/monitor_proxy.py 8081

# 5. 冒烟测试
curl -s http://127.0.0.1:8081/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model":"DeepSeek-R1-Distill-Qwen-14B-Q6_K",
      "messages":[{"role":"user","content":"你好"}],
      "max_tokens":50}'

# 6. 打开面板
open http://127.0.0.1:8081/dashboard

# 7. 禁止睡眠
sudo pmset -a sleep 0
附录 B:关键路径
| 内容 | 路径 |
|---|---|
| 模型文件 | ~/llm-models/models/Mozilla--DeepSeek-R1-Distill-Qwen-14B-llamafile/snapshots/master/ |
| 模型软链接 | ~/llm-models/DeepSeek-R1-14B-Q6_K.llamafile |
| 监控代理 | ~/llm-models/monitor_proxy.py |
| 模型日志 | ~/llm-models/llama.log |
| 开机自启 | ~/Library/LaunchAgents/com.zhoubo.llamafile.plist |
附录 C:模型版本时间线
| 时间 | 事件 | 对这台机器的意义 |
|---|---|---|
| 2024-09 | Qwen2.5 系列发布 | 成为 R1 Distill 的底座 |
| 2025-01-20 | DeepSeek-R1 及 6 个 Distill 模型开源 | 14B Qwen 版可用 |
| 2025-03-06 | QwQ-32B 发布 | 32B 推理模型,24GB 勉强 |
| 2025-04-29 | Qwen3 发布(含思考模式) | 可切换推理/闲聊 |
| 2025-05-28 | R1-0528 升级,Distill 出 Qwen3-8B | 8B 数学更强,代码深度不及 14B |
| 2026-04-24 | DeepSeek-V4 预览版开源 | 最小 53GB,本地不可行 |
| 2026-08 | Qwen3.8 27B | 知识最新,但 24GB 卡线 |
本文记录于 2026-10-31,实测环境:Mac mini M2 / 24GB / macOS 14.8.5 / llamafile 0.9.2。
评论 (0)
还没有评论,来抢沙发。